
Rubin HPC: Nvidia bannt „mehr als 50.000 CUDA-Kerne“ auf „eine“ GPU


Nvidia hat mit Rubin HPC eine neue GPU für High Performance Computing vorgestellt. Der Beschleuniger ergänzt die normale Rubin-GPU um eine stärker auf wissenschaftliche Berechnungen und Datenverarbeitung ausgelegte Architektur. Im Mittelpunkt stehen klassische Simulationen, FP64-Rechenleistung und die Kombination mit KI-Agenten.
Mehr als 50.000 CUDA-Kerne auf einer GPU
Die auffälligste technische Neuerung der Rubin-HPC-GPU ist ihre Rechendichte: Nvidia spricht von „mehr als 50.000 CUDA-Kernen auf einem einzelnen Grafikprozessor“. Wie bei der regulären Rubin-GPU dürften wieder mindestens zwei Dies gemeint sein, die zu „einer“ GPU zusammengesetzt werden – das zumindest legt der vereinfachte Die-Shot nahe, den Nvidia im Rahmen der Supercomputing-Konferenz SC26 veröffentlicht hat, der im Grunde genommen aber nahezu vollständig der bisherigen Rubin-GPU entspricht.
Damit setzt der Hersteller einen neuen Schwerpunkt innerhalb der Rubin-Plattform. Während die reguläre Rubin-GPU insbesondere auf die Beschleunigung von KI-Modellen und deren Inferenz ausgelegt ist, soll Rubin HPC klassische wissenschaftliche Rechenlasten mit hoher Effizienz bearbeiten.
Dazu zählen unter anderem Klimamodelle, Simulationen für die Materialforschung, technische Berechnungen, Genomanalysen und Finanzrisikoberechnungen. Gemeinsam ist diesen Anwendungen, dass sie häufig große Datenbestände verarbeiten, dabei aber nur auf einzelne, räumlich verteilte Werte zugreifen. Die Rechenwerke müssen deshalb kontinuierlich mit Daten versorgt werden, um ihre theoretische Leistung tatsächlich auszuschöpfen.
Genau hier setzt Nvidia mit einer ausgewogeneren Architektur aus Rechenleistung und Datenbewegung an. Neben der hohen Zahl an CUDA-Kernen nennt das Unternehmen eine neue Sparse-Data-Acceleration-Funktion. Sie soll den Datentransport bei unregelmäßigen Zugriffsmustern beschleunigen und verhindern, dass Recheneinheiten auf benötigte Daten warten müssen.
Beschleunigung für Sparse Matrices und Stencil-Berechnungen
Konkret nennt Nvidia drei wichtige Anwendungsmuster: Sparse-Matrix-Operationen, Stencil-Berechnungen sowie Sortier- und Reduktionsoperationen.
Bei Sparse-Matrix-Berechnungen enthalten Matrizen viele Nullen oder anderweitig nicht relevante Einträge. Eine effiziente Verarbeitung muss deshalb nicht nur die eigentlichen Rechenoperationen beschleunigen, sondern auch die oftmals unregelmäßigen Speicherzugriffe möglichst effizient organisieren.
Stencil-Berechnungen wiederum kommen beispielsweise bei der numerischen Simulation physikalischer Prozesse zum Einsatz. Dabei wird ein Wert anhand seiner unmittelbaren Nachbarschaft in einem räumlichen oder zeitlichen Gitter berechnet. Solche Operationen sind unter anderem für Strömungssimulationen und Klimamodelle relevant.

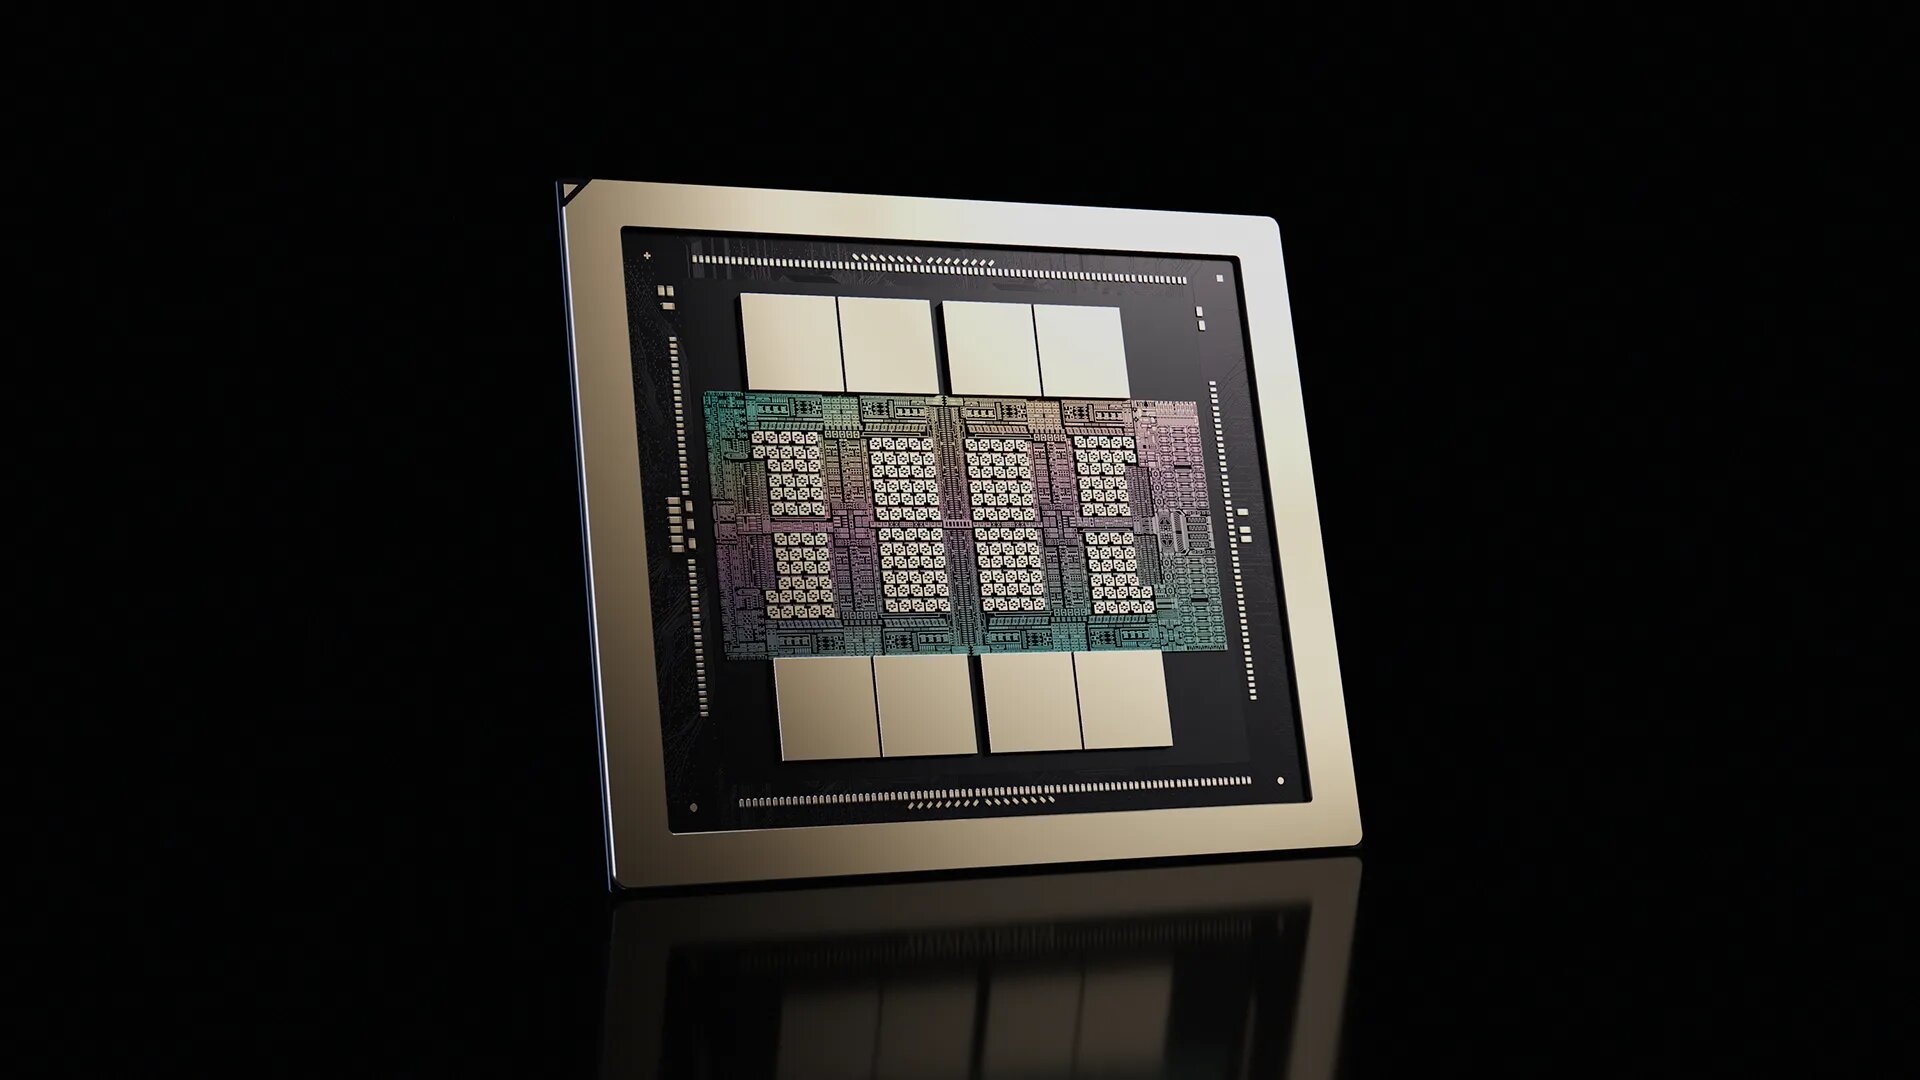
Die neue Datenbeschleunigung soll diese wiederkehrenden Muster direkt adressieren. Nvidia verspricht damit nicht lediglich mehr theoretische Rechenleistung, sondern eine bessere Auslastung der vorhandenen Rechenwerke. Konkrete Angaben zur internen Implementierung der Sparse Data Acceleration, etwa zu zusätzlichen Funktionseinheiten oder speziellen Speicherstrukturen, macht der Hersteller in der Ankündigung allerdings noch nicht.
NVLink der siebten Generation
Auch bei der Kommunikation zwischen mehreren GPUs gibt es eine Neuerung. Rubin HPC verwendet NVLink der siebten Generation und ist damit nicht auf die sechste Generation der regulären Rubin-GPU beschränkt.
NVLink verbindet Grafikprozessoren mit hoher Bandbreite und niedriger Latenz. Das ist insbesondere für große Simulationen wichtig, deren Daten und Berechnungen über mehrere Beschleuniger verteilt werden müssen. Die siebte Generation soll die GPU-zu-GPU-Kommunikation weiter beschleunigen und damit auch die Skalierung auf größere HPC-Systeme verbessern.
Nvidia nennt bislang allerdings weder die konkrete bidirektionale Bandbreite noch die Zahl der NVLink-Verbindungen oder die Speicherausstattung der neuen GPU. Ein direkter quantitativer Vergleich mit der regulären Rubin-GPU ist daher noch nicht möglich.
Einsatz zusammen mit KI-Agenten
Rubin HPC ist außerdem Teil einer Entwicklung, bei der Nvidia klassische Simulationen und agentische KI enger miteinander verzahnen möchte. KI-Agenten sollen eigenständig Hypothesen entwickeln, unterschiedliche Materialien oder Moleküle untersuchen und anschließend Simulationen anstoßen, um ihre Annahmen zu überprüfen.
Die Ergebnisse fließen wiederum in die nächsten Schritte der Agenten ein. Es entsteht ein Kreislauf aus Hypothese, Simulation und Verfeinerung. Je schneller die zugrunde liegenden Berechnungen abgeschlossen sind, desto mehr Varianten lassen sich innerhalb eines bestimmten Zeitraums untersuchen.
Dafür sollen auch die CUDA-X-Bibliotheken eine wichtige Rolle spielen. Sie stellen optimierte Implementierungen komplexer Algorithmen bereit, die von den Agenten für wissenschaftliche Berechnungen und Datenanalysen genutzt werden können.
Rubin HPC soll 2028 einsatzbereit sein
Nvidia erwartet die Verfügbarkeit von Rubin HPC im Jahr 2028. Bis dahin dürften weitere technische Details zur Architektur und zur Einbindung in die Vera-Rubin-Plattform folgen.

- MrH OpenCL Bench (neu!)
- Blender Benchmark (neu!)
- 3DMark Steel Nomad + X
- Cinebench 2026
- Apple M1 – M6
