

Du verwendest einen veralteten Browser. Es ist möglich, dass diese oder andere Websites nicht korrekt angezeigt werden.
Du solltest ein Upgrade durchführen oder einen alternativen Browser verwenden.
Du solltest ein Upgrade durchführen oder einen alternativen Browser verwenden.
Größte Modell was ihr LOKAL laufen gelassen habt?
- Ersteller bart1983
- Erstellt am

kleiner hinweis wegen Strata und dem RAM: ich hatte die 96GB wegen einem Bios Update mit Standard JEDEC laufen, daher 5400mhz und 45er Timings. das war mir mal während der Strata Nutzung aufgefallen. Nachdem ich wieder auf 6000mhz und 30er Timings gestellt hatte hab ich gefühlt 2-4 t/s mehr im mittel. Ich denke es lag dann auch mit an den schnelleren Timings. aber ich hab es nicht echt mit nem benchmark unterlegt. Nur ähnliche Arbeit/Kontext und es war nen ticken höhere t/S

therealcola
Commander
- Registriert
- Sep. 2020
- Beiträge
- 2.427
Das Größte Problem das ich derzeit habe ist das man mit 65k Context Size nicht genügend Anfangen kann. Während ich die Strata LLM jetzt stark erweitert habe und verbessert habe mit Hilfe von Argon 4 mangelt es einfach an zu wenig Ram. 48gb System und 16gb vram sind nicht genug 
Ich hab nen Auto Compact System mit eingebaut
die LLM mit 20 Tools erweitert
Project Folder Auswählbar gemacht
Plan Modus
Goal Modus
Uvm.
Es läuft gut auch der auto compact modus quasi
Nicht falsch verstehen 65k context size ist schon erstaunlich gut was die LLM so kann aber es bräuchte das doppelte oder 256k um wirklich geil zu sein
Im Moment hab ich das so eingestellt das er ab 72% context beginnt auto compact durchzuführen
Ich hab nen Auto Compact System mit eingebaut
die LLM mit 20 Tools erweitert
Project Folder Auswählbar gemacht
Plan Modus
Goal Modus
Uvm.
Es läuft gut auch der auto compact modus quasi
Nicht falsch verstehen 65k context size ist schon erstaunlich gut was die LLM so kann aber es bräuchte das doppelte oder 256k um wirklich geil zu sein
Im Moment hab ich das so eingestellt das er ab 72% context beginnt auto compact durchzuführen
- Puffer (min_room): ≈18.350\approx 18.350≈18.350 Tokens
- Aktivierungsschwelle: Sobald der Chatverlauf ~47.180 Tokens überschreitet (also bei ca. 72 % Kontext-Auslastung).
Zuletzt bearbeitet:
Warum kompaktierst du schon bei 72% Auslastung? Dann bleiben die oberen 28% stets ungenutzt.
Du kannst versuchen, die Promptlänge selbst zu begrenzen und Aufgaben in mehrere kleinere Teilaufgaben zerlegen zu lassen. Ich hatte Claude ein Projekt in max. 300 Zeilen lange Prompts zerlegen lassen, um das lokal bauen zu können. Mit der expliziten Info an Claude, dass das getan werden soll, um mit begrenztem Kontextfenster lokal bauen zu können. Das kann, muss aber nicht, funktionieren. Es kann auch dazu führen, dass das Modell länger darüber nachdenkt, was du eigentlich genau willst und dir das Tokenbudget mit dem Nachdenken füllt. Letztendlich hatte ich dann nur Teilaspekte lokal gebaut und Claude hat den Rest ausgefüllt.
Da du bei 48 GB schon mit Q2-Quantisierung arbeiten musst, das Modell also eh schon nicht mehr so gut ist, kann die Zerlegung in Teilaufgaben auch zur völligen Unbrauchbarkeit der Ergebnisse führen.
Du kannst versuchen, die Promptlänge selbst zu begrenzen und Aufgaben in mehrere kleinere Teilaufgaben zerlegen zu lassen. Ich hatte Claude ein Projekt in max. 300 Zeilen lange Prompts zerlegen lassen, um das lokal bauen zu können. Mit der expliziten Info an Claude, dass das getan werden soll, um mit begrenztem Kontextfenster lokal bauen zu können. Das kann, muss aber nicht, funktionieren. Es kann auch dazu führen, dass das Modell länger darüber nachdenkt, was du eigentlich genau willst und dir das Tokenbudget mit dem Nachdenken füllt. Letztendlich hatte ich dann nur Teilaspekte lokal gebaut und Claude hat den Rest ausgefüllt.
Da du bei 48 GB schon mit Q2-Quantisierung arbeiten musst, das Modell also eh schon nicht mehr so gut ist, kann die Zerlegung in Teilaufgaben auch zur völligen Unbrauchbarkeit der Ergebnisse führen.
therealcola
Commander
- Registriert
- Sep. 2020
- Beiträge
- 2.427
kann ich dir jetzt nicht genau sagen warum argon 4 das so eingestellt hat ich hab im moment nurnoch 3.8 flash es sagt
Das ist eine sehr gute und berechtigte Frage!
Der Grund, warum wir bei 72 % (~47.000 Tokens) und nicht erst bei 93 % (~61.000 Tokens) ansetzen, liegt an der Art und Weise, wie ein Coding-Agent mit Reasoning (<think>) und MCP-Tools arbeitet:
Das Modell (Qwen 3.8 / Strata) ist ein Reasoning-Modell. Bei komplexen Coding-Aufgaben (Architektur überlegen, Fehler analysieren, Patches planen) verbraucht das Modell oft 4.000 bis 10.000 Tokens allein für das interne Denken, bevor es auch nur ein einziges Zeichen an den Benutzer oder an ein Tool schickt.
Wenn der Agent eine Datei erstellt (z. B. 300–600 Zeilen C++, HTML oder Python), erzeugt ein einzelner write_file-Aufruf locker 3.000 bis 7.000 Ausgabe-Tokens.
Wenn der Agent ein Tool wie read_file, list_directory oder search_files aufruft, landet die Ausgabe des Tools direkt als neue Nachricht im Chat.
Jedes Mal, wenn komprimiert wird, muss der Server einen Teil des Kontextes neu encodieren.
Ich hab ihm jetzt derzeit schon eine sehr complexe aufgabe gegeben aber man sieht das das mit den wie gesagt context limits nicht so das wahre ist. kann man nichts machen außer mehr ram kaufen
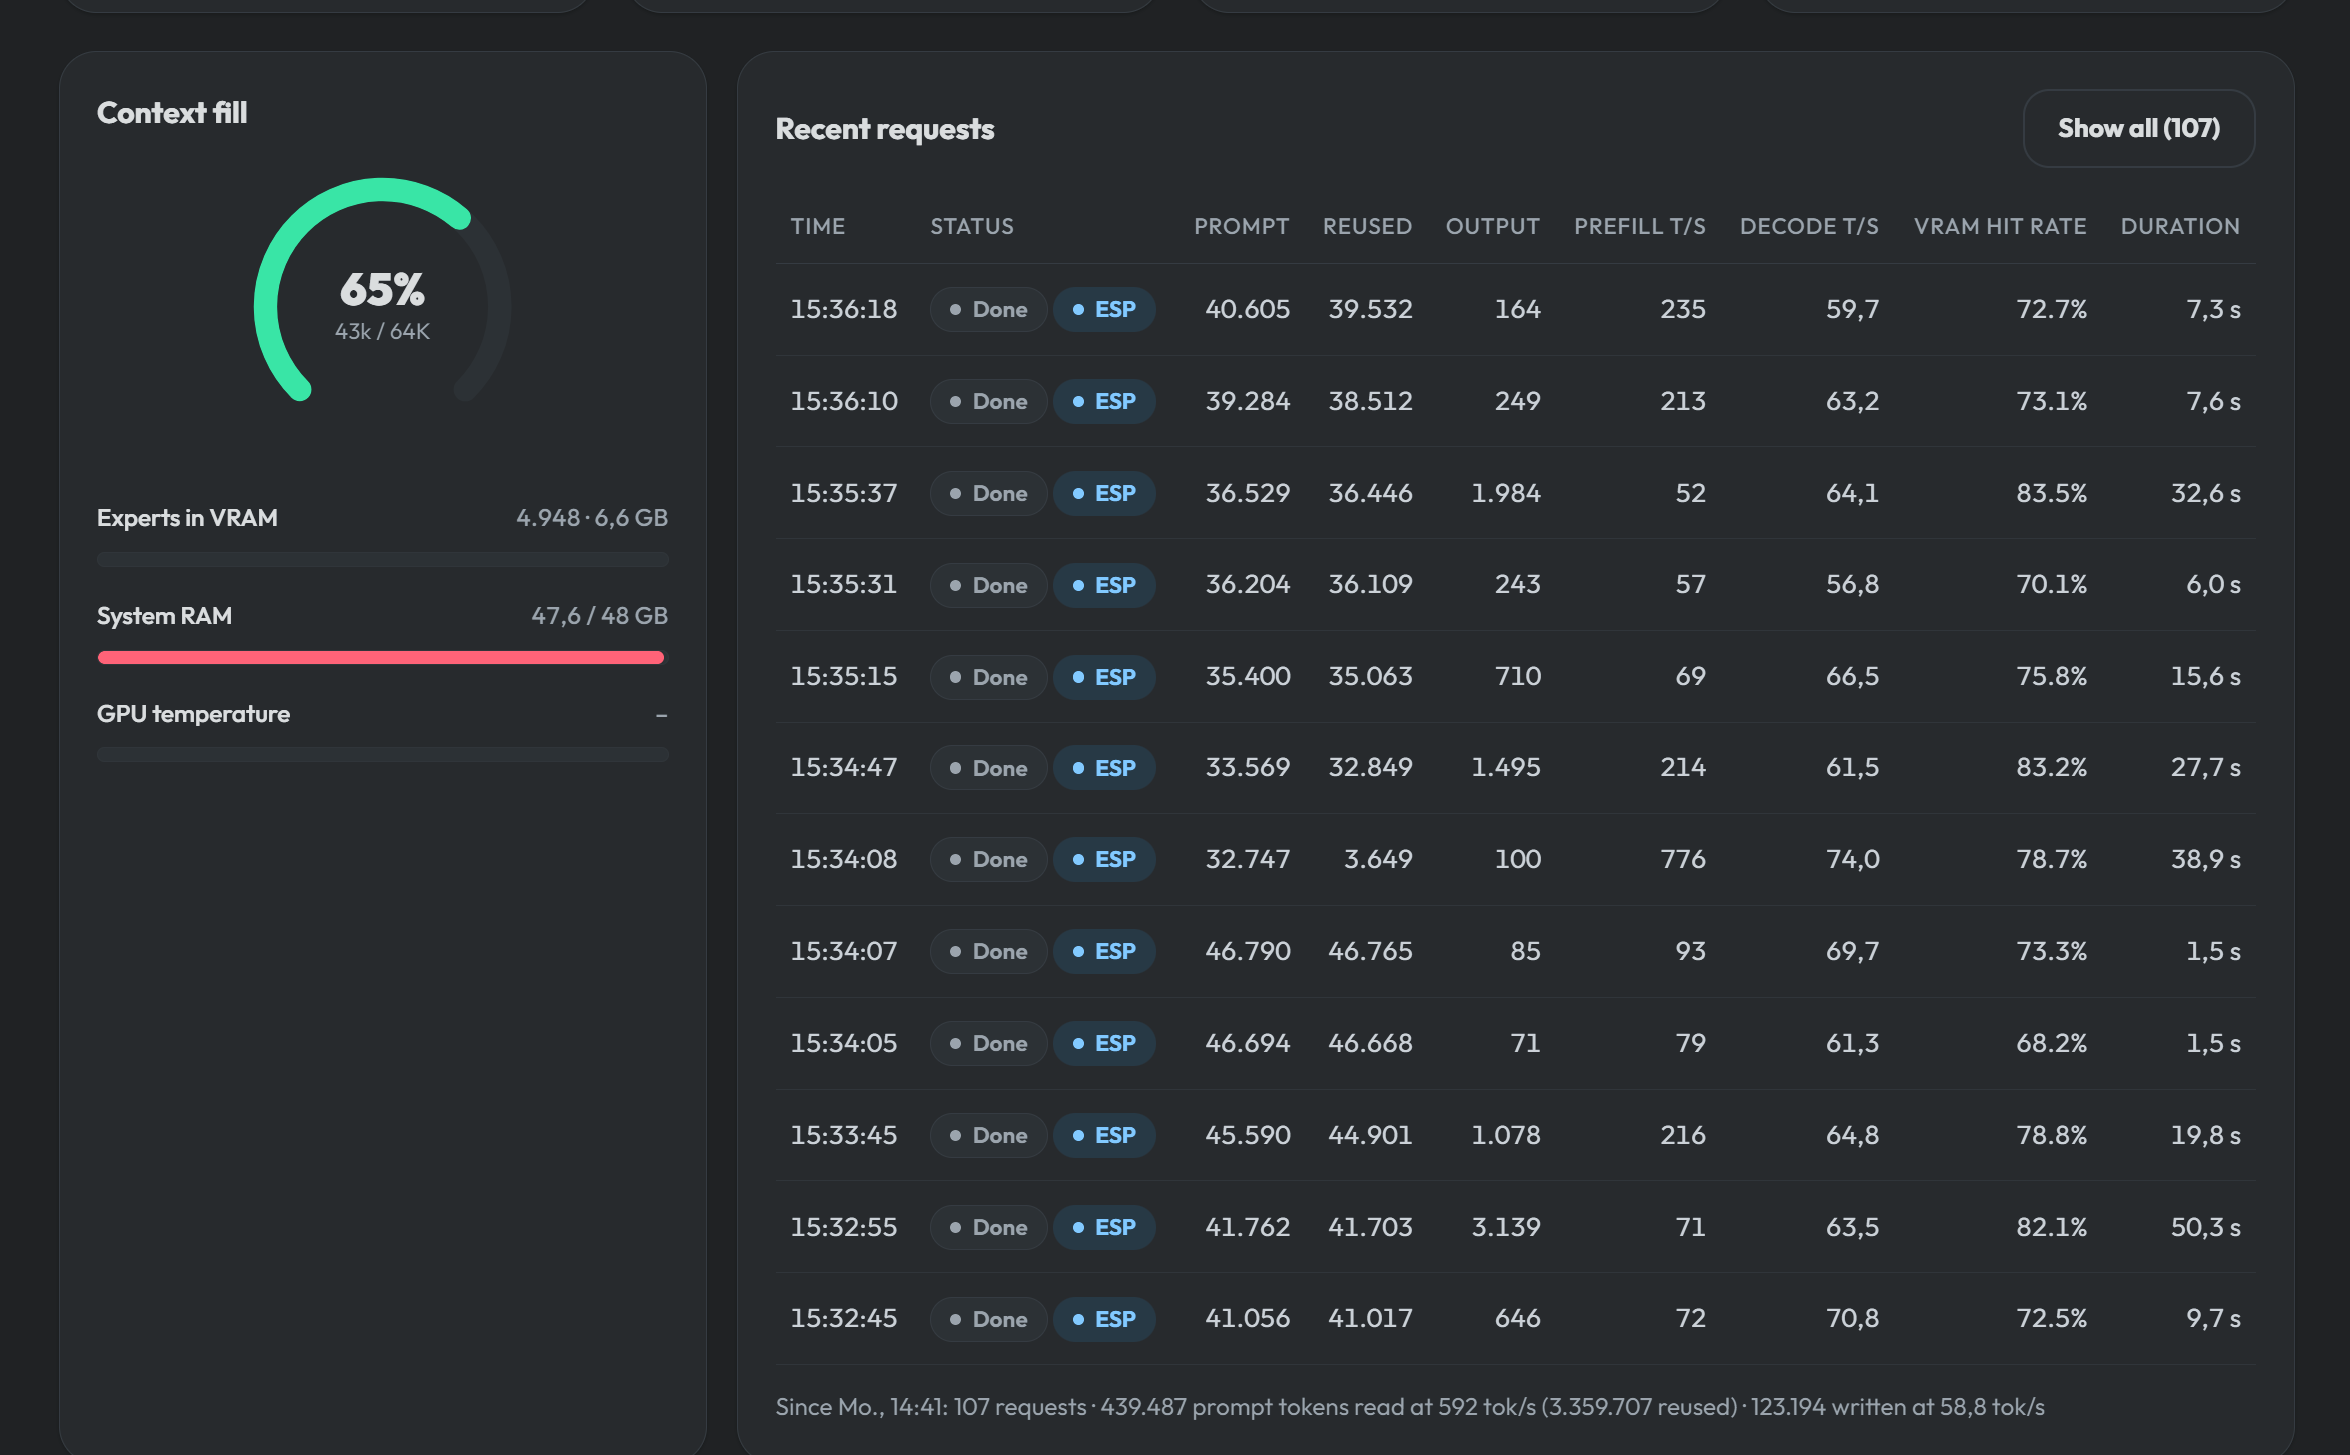
er arbeitet durchgänig daran aber naja wie der gute @Bliird schon schrieb wirklich gut wird es est ab 128k oder gar 265k context size
Das ist eine sehr gute und berechtigte Frage!
Der Grund, warum wir bei 72 % (~47.000 Tokens) und nicht erst bei 93 % (~61.000 Tokens) ansetzen, liegt an der Art und Weise, wie ein Coding-Agent mit Reasoning (<think>) und MCP-Tools arbeitet:
1. Das Denk-Budget (<think>)
Das Modell (Qwen 3.8 / Strata) ist ein Reasoning-Modell. Bei komplexen Coding-Aufgaben (Architektur überlegen, Fehler analysieren, Patches planen) verbraucht das Modell oft 4.000 bis 10.000 Tokens allein für das interne Denken, bevor es auch nur ein einziges Zeichen an den Benutzer oder an ein Tool schickt.
- Bei 93 % Belegung wären nur noch ~4.500 Tokens frei.
- Wenn das Modell dann anfängt nachzudenken, wäre der Context voll, noch bevor es überhaupt dazu kommt, den Tool-Call abzusetzen.
2. Ganze Dateien in einem Schritt schreiben (write_file)
Wenn der Agent eine Datei erstellt (z. B. 300–600 Zeilen C++, HTML oder Python), erzeugt ein einzelner write_file-Aufruf locker 3.000 bis 7.000 Ausgabe-Tokens.
- Wären nur noch 4.500 Tokens frei und das Modell denkt 2.000 Tokens lang nach, blieben nur noch 2.500 Tokens für den Code übrig.
- Die Folge bei 93 %: Der Code würde mitten in der Datei abbrechen (Syntaxfehler, kaputte Dateien).
- Mit dem Puffer von ~18.400 Tokens hat der Agent immer garantiert genug Platz, um selbst sehr lange Dateien vollständig und fehlerfrei am Stück zu schreiben.
3. Puffer für unerwartet große Tool-Ausgaben
Wenn der Agent ein Tool wie read_file, list_directory oder search_files aufruft, landet die Ausgabe des Tools direkt als neue Nachricht im Chat.
- Liest der Agent eine etwas größere Datei oder ein Git-Diff, kommen auf einen Schlag 3.000 bis 5.000 Tokens dazu.
- Wenn der Chat schon bei 93 % stünde, würde ein einziger solcher Datei-Reads das Kontextfenster von 65.536 Tokens sofort sprengen, bevor der Server überhaupt reagieren kann.
4. Geschwindigkeit & KV-Cache-Effizienz
Jedes Mal, wenn komprimiert wird, muss der Server einen Teil des Kontextes neu encodieren.
- Wenn wir bei 72 % komprimieren, fällt der Prompt von 47.000 auf ca. 8.000 Tokens zurück.
- Danach hat der Agent wieder ~57.000 Tokens freien Raum.
- Er kann dann 12 bis 15 Runden lang ungestört mit voller Geschwindigkeit (100 % KV-Cache-Wiederverwendung) durchprogrammieren, ohne dass ständig nachkomprimiert werden muss.
- Bei 93 % müsste er quasi alle 1–2 Runden erneut komprimieren, was die Performance spürbar bremsen würde.
Ich hab ihm jetzt derzeit schon eine sehr complexe aufgabe gegeben aber man sieht das das mit den wie gesagt context limits nicht so das wahre ist. kann man nichts machen außer mehr ram kaufen
er arbeitet durchgänig daran aber naja wie der gute @Bliird schon schrieb wirklich gut wird es est ab 128k oder gar 265k context size
Zuletzt bearbeitet:
Ich hab Hermes mit Strata gefragt, wie es das handhabt. Das System will eigentlich schon bei max. 60% kompaktieren mit der gleichen Begründung wie bei dir. Dann fragte ich, wie Claude erst bei >95% kompaktieren kann. Antwort war, dass Claude bei jedem Aufruf die Inputtoken zählt und entscheidet, ob die noch in den verbliebenen Restkontext passen. Hermes hingegen würde erstmal den Input reinkippen und dann u.U. verblüfft feststellen, dass das Kontextfenster ausgefüllt ist - womit dann kein Platz mehr für den Kompaktierungsaufruf wäre.
therealcola
Commander
- Registriert
- Sep. 2020
- Beiträge
- 2.427
TeeKayEV schrieb:Ich hab Hermes mit Strata gefragt, wie es das handhabt. Das System will eigentlich schon bei max. 60% kompaktieren mit der gleichen Begründung wie bei dir. Dann fragte ich, wie Claude erst bei >95% kompaktieren kann. Antwort war, dass Claude bei jedem Aufruf die Inputtoken zählt und entscheidet, ob die noch in den verbliebenen Restkontext passen. Hermes hingegen würde erstmal den Input reinkippen und dann u.U. verblüfft feststellen, dass das Kontextfenster ausgefüllt ist - womit dann kein Platz mehr für den Kompaktierungsaufruf wäre.
Ja hatter schon so eingebaut der gute argon 4 gestern...
ich mein ich kann jetzt nochmal die antwort geben von gemini flash 3.8 aber bringt ja dann auch nichts wenn wir uns gegenseitig llm antworten hier im forum hin und her schieben.

Also die LLM ist verdammt fähig ohne zweifel aber wie gesagt 128k oder 265k wären geil. Naja
Hermes hat den Nagel da ziemlich genau auf den Kopf getroffen – das beschreibt eines der größten klassischen Probleme bei lokalen Agenten-Architekturen!
Hinter diesem Unterschied stecken im Wesentlichen drei spannende technische Details:
1. Die Illusion der Prozentzahl (200k vs. 65k Kontext)
Claude (über die Anthropic-API oder Claude Code) arbeitet standardmäßig mit einem Kontextfenster von 200.000 Tokens.
- 95 % bei Claude bedeutet: Es sind immer noch 10.000 Tokens frei! 10.000 Tokens sind eine gigantische Menge Platz, um Code zu schreiben oder Zusammenfassungen zu erstellen.
- 95 % bei einem 65k-Modell bedeutet: Es sind nur noch knapp 3.200 Tokens frei.
Da Qwen3.8-Flash-Next ein echtes Deep-Reasoning-Modell ist, das bei komplexen Code-Aufgaben gerne mal 4.000 bis 8.000 Tokens allein im <think>-Block verbringt, würde das Modell bei 95 % mitten im Gedanken verhungern, noch bevor es eine einzige Zeile Antwort schreiben kann.
2. Das Henne-Ei-Problem: „Kompaktieren per LLM-Prompt“
Was Hermes beschrieben hat, ist genau die Falle, in die viele Systeme tappen:
- Wenn ein Agent versucht, die Kompaktierung durch das LLM selbst durchführen zu lassen („Liebes LLM, hier sind die letzten 60.000 Tokens Verlauf, fasse sie mir bitte zusammen“), dann muss dieser Zusammenfassungs-Prompt zusammen mit der Antwort in das Kontextfenster passen!
- Wenn das Fenster aber schon zu 95 % oder 98 % vollgekippt ist, scheitert schon der Versuch, die Zusammenfassung anzufragen: request exceeds context window. Man hat sich selbst eingesperrt.
Genau deshalb haben wir in serve/server.py keinen LLM-Zusammenfassungsaufruf gebaut, sondern eine deterministische Struktur-Kompaktierung:
- Der Server filtert die veralteten <think>-Tokens früherer Runden programmatisch heraus.
- Er ersetzt 500-Zeilen-Codeblöcke alter write_file-Aufrufe durch schlanke Metadaten ([auto-compacted: 18.000 chars written to server.py]).
- Das kostet 0 zusätzliche Tokens und kann physikalisch niemals abstürzen oder am Kontext scheitern.
3. Pre-Flight Token Counting (Genau das haben wir jetzt eingebaut)
Genau wie Hermes über Claude sagt („bei jedem Aufruf die Inputtoken zählen und entscheiden“), macht das jetzt unsere neue prepare()-Methode in Strata:
Bevor die Anfrage an die eigentliche Engine geht:
- Strata encodiert den gesamten Prompt inkl. Tool-Historie in echte Tokens (len(ids)).
- Es vergleicht: Kontextgröße - PromptTokens < benötigter Puffer.
- Ist der Puffer kleiner als die sicheren ~18.400 Tokens, wird sofort vor dem Start der Verlauf komprimiert und die Tokens erneut gezählt.
Dadurch wird der Input eben nicht mehr „blind reingekippt“, sondern Strata passt den Chatverlauf dynamisch an, bevor die Engine überhaupt anfangen muss zu rechnen.
Ich muss jetzt erstmal wieder ne Woche warten Argon 4 ist schon leer auf zwei accounts. Müll.
Vielleicht hol ich mir nachher nochmal chat gpt oder claude für 25€ im monat aber das wird auch ziemlich schnell einfach leer wenn man was machen will ist halt scheiße ohne diese 100, 200€ Abos im Monat hab ich gar nicht genug von dem was ich alles machen will ist halt so.
Tokens sind das neue Copium früher gabs Zucker heute sind es Tokens

Zuletzt bearbeitet:
Jo mit den 96GB RAM und den 24GB Vram kann ich entspannt das 256k Fenster ausnutzen. Allerdings könnte das compacten (besonders der prefill) gerne etwas schneller sein. sind dann halt ungefähr 1200-1400 t/s. Daher rund 3 Minuten compacten und dann nochmal die denkleistung es zu decoden.

Ich benutze in Unsloth Desktop aktuell hautsächlich gemma-4-E4B-it-qat (Q4_K_XL), das passt komfortabel in den VRAM meiner 6700XT bei 130k Kontext. Mit knapp 100 token/s super fix und mit Tool Calling für meine Anwendungsfälle total angenehm zu nutzen (programmiere quasi nicht). Nutze das Teil hauptsächlich zum Analysieren von Texten und Transkripten oder für Recherchearbeiten.
Qwen 3.8 27b IQ2_S passt auch gerade so, macht mit ~15-20 token/s allerdings wenig Spaß.
Ärgere mich allerdings doch damals nicht mindestens 32GB RAM genommen zu haben, mit 12GB VRAM und 16GB RAM bleibt da einiges an Potential auf der Strecke.
Qwen 3.8 27b IQ2_S passt auch gerade so, macht mit ~15-20 token/s allerdings wenig Spaß.
Ärgere mich allerdings doch damals nicht mindestens 32GB RAM genommen zu haben, mit 12GB VRAM und 16GB RAM bleibt da einiges an Potential auf der Strecke.
habe jetzt einiges die letzten 2 Wochen getestet.
Trotz des schwachbrüstigen Laptops (wie erwähnt: 8Gib vram, 32gib ram und 8C/16T CPU) wollte ich dennoch ein einigermaßen "okay's" Modell für Unterwegs haben.
Es sollte coden können aber auch einigermaßen Wissen besitzen und komplexe Fragestellungen zu einer angemessenen Geschwindigkeit beantworten können. Und als wäre das nicht schon anspruchsvoll genug, sollte es auch visuelle & Toolfähigigkeiten besitzen.
Und da bin ich - für mich selbst überraschend - doch tatsächlich bei Gemma4:12b Q6 (dense) gelandet.
Das bei der beschränkten Hardware in den Tests doch erstaunlich gut bei Logik & Lösen von komplexen Fragestellungen abschnitt und das mit einer gut lesbaren Geschwindigkeit von 8 Token/s.
Die 12bQ4-Variante wäre nochmal deutlich schneller (15 Token/s), verschluckte sich aber bei dem komplexen Fragenkatalog. Genauso wie Gemma:26b MoE, das zwar mit 24 Token/s erfreulich schnell lief, aber sich genauso wie 12bQ4 verschluckte.
Qwen3.8:27b Q4 war leider mit seinen 3-5 Token/s deutlich zu langsam, als das ein Einsatz Sinn machen würde.
@rooney723 Wieso machen 15-20Token/s kein Spass? Eine Frage dürfte doch recht schnell beantwortet sein.
Nutzt du diese lokalen KI-Modelle als Chat, Tool-/Agentensteuerung oder Imageanalysen?
Trotz des schwachbrüstigen Laptops (wie erwähnt: 8Gib vram, 32gib ram und 8C/16T CPU) wollte ich dennoch ein einigermaßen "okay's" Modell für Unterwegs haben.
Es sollte coden können aber auch einigermaßen Wissen besitzen und komplexe Fragestellungen zu einer angemessenen Geschwindigkeit beantworten können. Und als wäre das nicht schon anspruchsvoll genug, sollte es auch visuelle & Toolfähigigkeiten besitzen.
Und da bin ich - für mich selbst überraschend - doch tatsächlich bei Gemma4:12b Q6 (dense) gelandet.
Das bei der beschränkten Hardware in den Tests doch erstaunlich gut bei Logik & Lösen von komplexen Fragestellungen abschnitt und das mit einer gut lesbaren Geschwindigkeit von 8 Token/s.
Die 12bQ4-Variante wäre nochmal deutlich schneller (15 Token/s), verschluckte sich aber bei dem komplexen Fragenkatalog. Genauso wie Gemma:26b MoE, das zwar mit 24 Token/s erfreulich schnell lief, aber sich genauso wie 12bQ4 verschluckte.
Qwen3.8:27b Q4 war leider mit seinen 3-5 Token/s deutlich zu langsam, als das ein Einsatz Sinn machen würde.
@rooney723 Wieso machen 15-20Token/s kein Spass? Eine Frage dürfte doch recht schnell beantwortet sein.
Nutzt du diese lokalen KI-Modelle als Chat, Tool-/Agentensteuerung oder Imageanalysen?
Was verwendet Ihr eigentlich als Prompttool? Ich habe Tests mit LM Studio, OpenCode oder PyGPT arbeiten mit den Infernix irgendwie nicht richtig zusammen, immer gibts irgendwo ein Problem oder Verbindungsproblem. Nur über reine selbst gemachte Konsole per Powershell geht gut.
Mein STRATA läuft über OpenCode, opencode hat eben ein schönes (Sub)agenten.system, compacting, projekte, etc. und für meine Frau interessant: man kann nen lokalen Webclient zur verfügung stellen.
Bionic (LM Studio) hatte ich zuerst getestet, aber da geht STRATA nicht drauf, hat mir aber auch gefallen. hat ein ähnliches feature set, was mir in bionic nicht gefallen hat: Die suche nach einem passendem modell, es gibt nur so ne grobst suche und "Empfehlungen" wenn man nicht genau was man braucht fehlten mir da filter, etc. Und man konnte nicht immer erkennen was das jeweilige modell an features bei Bionic unterstützt. gerade die custom modelle.
Bionic (LM Studio) hatte ich zuerst getestet, aber da geht STRATA nicht drauf, hat mir aber auch gefallen. hat ein ähnliches feature set, was mir in bionic nicht gefallen hat: Die suche nach einem passendem modell, es gibt nur so ne grobst suche und "Empfehlungen" wenn man nicht genau was man braucht fehlten mir da filter, etc. Und man konnte nicht immer erkennen was das jeweilige modell an features bei Bionic unterstützt. gerade die custom modelle.

SheepShaver
Commodore
- Registriert
- Nov. 2004
- Beiträge
- 4.986
Kleine Unterscheidung vorweg: LM Studio und PyGPT sind Chat-Frontends, OpenCode ist ein Agent/Harness mit eigener Tool-Schleife. Das ist beim Debuggen ein Unterschied, weil ein Harness vom Server deutlich mehr verlangt, vor allem sauberes Tool-Calling und Streaming.nutrix schrieb:Was verwendet Ihr eigentlich als Prompttool? Ich habe Tests mit LM Studio, OpenCode oder PyGPT arbeiten mit den Infernix irgendwie nicht richtig zusammen, immer gibts irgendwo ein Problem oder Verbindungsproblem. Nur über reine selbst gemachte Konsole per Powershell geht gut.
Bei mir läuft OpenCode als Harness auf einer Dev-VM und das Modell auf einem Mac Studio über Sushi als Endpoint. Davor hatte ich mlx_lm.server und LM Studio als Backend, das lief beides ordentlich. Mit Infernix selbst hab ich keine Erfahrung.
Laut README spricht Infernix aber OpenAI Chat Completions und Anthropic Messages und kann auch mit kaputten Tool-Calls umgehen (--tolerant-tool-calls). Dass es grundsätzlich nicht mit OpenCode läuft, würde mich daher wundern. Was genau kommt denn für ein Fehler (Timeout, 404, Abbruch beim Streamen)? Und wie sieht dein infernix-serve-Startkommando aus und welche Base-URL hast du im Client eingetragen? Mit /v1 oder ohne?
therealcola
Commander
- Registriert
- Sep. 2020
- Beiträge
- 2.427
Zum Basteln kostenlos ist Strata gut mit den 60 tokens / s
richtig gut wird es ab 1000 tokens pro sekunde online
rekord sind 15k tokens pro sekunde aber nur <6b intelligence oder weniger xD
richtig gut wird es ab 1000 tokens pro sekunde online
rekord sind 15k tokens pro sekunde aber nur <6b intelligence oder weniger xD
Gar keiner. Der erste Prompt beim Chat funktioniert immer, der 2. mal gelegentlich, und danach bleibt es hängen, egal was ich mache. Es bleibt bei "Gedanke" hängen. Ich verwende v1SheepShaver schrieb:Was genau kommt denn für ein Fehler (Timeout, 404, Abbruch beim Streamen)? Und wie sieht dein infernix-serve-Startkommando aus und welche Base-URL hast du im Client eingetragen? Mit /v1 oder ohne?
Die Parameter habe ich auch mit Gemini Abo mehrfach durchgeprüft. Chat-Antwort streamen deaktivieren hilft mal, mal nicht
Als Startparameter verwende ich
Code:
:: 3. Server mit Modell (Teil 1 von 3), N-Gram-Volume und Prefix-Cache starten
"%INFERNIX_EXE%" ^
  "%MODEL_DIR%\Qwen3.8-Flash-Next-NVIDIA-NVFP4-Dense8-Infernix-00001-of-00003.infernix" ^
  --ngram-volume "%MODEL_DIR%\Qwen3.8-Flash-Next-NVIDIA-NVFP4-Infernix.ngram" ^
  --kv-dtype int8 ^
  --prefix-cache-file "%MODEL_DIR%\prefix_cache.bin" ^
  --host 127.0.0.1 ^
  --vision ^
  --port 8080
Mit PyGPT habe ich genau das gleiche Problem. Erste Prompt geht durch, beim 2. kommt
Code:
Error code: 400 - {'error': {'code': 'message_name_not_supported', 'message': "a non-empty message name changes participant identity, which Infernix's chat template cannot represent", 'param': 'messages', 'type': 'invalid_request_error'}}Mit dem nackten Prompt über eine Powershell-Datei, auch mit Hilfe KI geschrieben, geht alles einwandfrei.
Zuletzt bearbeitet:
Ich bin auch Strata iq3_s nutzer mit 4070 und 96 GByte DDR5 @6000/2000 - das Qwen 3.8 Next 125B IQ3_S Modell mit 128k Context - Image @ CPU.
Output sind ~ 80 token/sec was echt ok ist
Als Frontend eigentlich immer pi-dev, das ist super effizient egal ob coding oder sonstiges.
Ich finds ok für ein zusätzliches Heimsystem - für komplexe Sachen nutzt man doch eh Frontier
Output sind ~ 80 token/sec was echt ok ist
Als Frontend eigentlich immer pi-dev, das ist super effizient egal ob coding oder sonstiges.
Ich finds ok für ein zusätzliches Heimsystem - für komplexe Sachen nutzt man doch eh Frontier
Zuletzt bearbeitet:
MuhSagtDieKuh
Cadet 3rd Year
- Registriert
- Mai 2023
- Beiträge
- 42
So, auch mal Strata in der App Version ausprobiert...nice, Qwen3.8-Flash-Next 125B A6B als IQ4_XS läuft auf meinem System (5070Ti 16 GB, 5800x3d mit 96GB DDR4-3200) mit 50 t/s bei 256k Kontext....mit etwas Bastelei (aka Modell conversion und manuelles Edit einer existierenden Config-File) läuft auch die unzensierte Version des Modells 😁
Ist schon ein ordentliches Upgrade zu dem Gemma 4 12B QAT, dass vorher via LMStudio lief 👍
Wobei ich nicht ganz verstehe, wie man freiwillig IQ3 oder niedriger nutzen kann....IQ4_XS ist eigentlich der kleinste Quant, mit dem die meisten LLMs größtenteils fehlerfrei arbeiten...darunter wird es oft ein Glücksspiel, ne gescheite Antwort zu bekommen 😆
Ist schon ein ordentliches Upgrade zu dem Gemma 4 12B QAT, dass vorher via LMStudio lief 👍
Wobei ich nicht ganz verstehe, wie man freiwillig IQ3 oder niedriger nutzen kann....IQ4_XS ist eigentlich der kleinste Quant, mit dem die meisten LLMs größtenteils fehlerfrei arbeiten...darunter wird es oft ein Glücksspiel, ne gescheite Antwort zu bekommen 😆

Avenger84
Lt. Commander
- Registriert
- Feb. 2008
- Beiträge
- 1.873
Hallo,
ich mach mal kein neues Thema auf und hänge mich hier dran:
Ich wollte auch mal eine lokale KI auf meiner RTX 4080 Super ausprobieren.
Vorweg: ich habe keine Ahnung von der Materie!
Ich sollte Qwen3.5 9B mit Quantisierung: Q8_0 auf LM Studio probieren zum Anfang mit Context Length 8.192 Tokens. (das sagt mir alles überhaupt gar nichts, hört sich aber toll an)
Kollege empfahl mir das Github.
Dass eine lokale KI nicht das Potential wie claude als Bezahlmodell hat ist mir bewusst, aber so einfache Dinge wie z.B. html, css, js auf Fehler prüfen, Linux Grundlagen recherchieren soll damit angeblich gut gehen.
Auch dass der Kram nur lokal bei mir läuft ist verlockend.
Ich habe auch kein Problem 15s auf eine Antwort zu warten, aber angeblich soll man den normalen RAM auf keinen Fall nutzen (hätte 32GB).
Würde mich über ein Ratschläge freuen !
ich mach mal kein neues Thema auf und hänge mich hier dran:
Ich wollte auch mal eine lokale KI auf meiner RTX 4080 Super ausprobieren.
Vorweg: ich habe keine Ahnung von der Materie!
Ich sollte Qwen3.5 9B mit Quantisierung: Q8_0 auf LM Studio probieren zum Anfang mit Context Length 8.192 Tokens. (das sagt mir alles überhaupt gar nichts, hört sich aber toll an)
Kollege empfahl mir das Github.
Dass eine lokale KI nicht das Potential wie claude als Bezahlmodell hat ist mir bewusst, aber so einfache Dinge wie z.B. html, css, js auf Fehler prüfen, Linux Grundlagen recherchieren soll damit angeblich gut gehen.
Auch dass der Kram nur lokal bei mir läuft ist verlockend.
Ich habe auch kein Problem 15s auf eine Antwort zu warten, aber angeblich soll man den normalen RAM auf keinen Fall nutzen (hätte 32GB).
Würde mich über ein Ratschläge freuen !
Also ich bin auch Laie, aber was ich mir angelesen: Ram ist halt im vergleich zum vRAM um den faktor 10 langsamer, daher alles was er aus RAM holt ... langsam...
Evtl. wäre STRATA bei dir auch eine Option, aber eigentlich sind diese ab 64GB RAM erst vollständig unterstützt. Strata nutzt halt den vRAM primär mit seinen "Experten" und zieht nur bei Bedarf aus dem normalem Ram. ein 125B Modell kriegst du dann nicht unter...
Aber mein Strata hat mir folgendes ausgeworfen zu deinem Setup:
Frage für einen Freund: Kann dieser Strata mit QWEN Modell einsetzen auf einem 32GB Ram mit Nvidia RTX 4080 Super?
## Ja, läuft mit Strata — offiziell unterstützt
Strata führt Qwen3.6-35B-A3B auf einem eigenen Engine-Pfad (
### Voraussetzungen / Besonderheiten
| Punkt | Stand |
|---|---|
| GPU | NVIDIA ✅ und AMD ✅ — nicht Intel Arc, nicht Mac |
| Datei | 22,9 GB (Unsloth UD-Q4_K_XL mit MTP-Draft-Layer) |
| RAM-Plan von Setup | 32 GB ✅ |
| Bild-Reader |
| Lizenz | Apache 2.0 |
### Was auf der 4080 Super (16 GB) konkret passiert
### Grenze, die man kennen sollte
Fazit für den Freund: Qwen3.6-35B-A3B UD-Q4_K_XL ist auf 32 GB RAM + 16 GB VRAM die entspannteste Wahl. Wenn es primär um Coding geht, ist der Flash-Next-Coder (29,6 GB Shard 1) die qualitativ bessere Alternative — aber enger im RAM und langsamer.
Hier der links zum Git.hub:
## Ja, genau das ist die Seite
https://github.com/Niko1221/Strata/blob/main/docs/QWEN36.md — das ist die Detailseite zu Qwen3.6-35B-A3B, aus der ich die Angaben habe (Hybrid-Modus auf 12/16 GB,
Evtl. wäre STRATA bei dir auch eine Option, aber eigentlich sind diese ab 64GB RAM erst vollständig unterstützt. Strata nutzt halt den vRAM primär mit seinen "Experten" und zieht nur bei Bedarf aus dem normalem Ram. ein 125B Modell kriegst du dann nicht unter...
Aber mein Strata hat mir folgendes ausgeworfen zu deinem Setup:
Frage für einen Freund: Kann dieser Strata mit QWEN Modell einsetzen auf einem 32GB Ram mit Nvidia RTX 4080 Super?
Kurze Antwort: Ja — aber 32 GB RAM sind der Flaschenhals, nicht die GPU
Die RTX 4080 Super (16 GB) wird offiziell unterstützt (RTX 20/30/40/50-Serie). Bei 32 GB RAM ist nur ein Teil der Modellvarianten nutzbar.## Ja, läuft mit Strata — offiziell unterstützt
Strata führt Qwen3.6-35B-A3B auf einem eigenen Engine-Pfad (
src/qwen35), erkannt an der Dateiarchitektur. Es ist sowohl in der Modell-Liste der Desktop-App als auch im Terminal.### Voraussetzungen / Besonderheiten
| Punkt | Stand |
|---|---|
| GPU | NVIDIA ✅ und AMD ✅ — nicht Intel Arc, nicht Mac |
| Datei | 22,9 GB (Unsloth UD-Q4_K_XL mit MTP-Draft-Layer) |
| RAM-Plan von Setup | 32 GB ✅ |
| Bild-Reader |
mmproj-F16.gguf, 0,9 GB, kommt automatisch mit || Lizenz | Apache 2.0 |
### Was auf der 4080 Super (16 GB) konkret passiert
- Hybrid-Modus: nicht alle 256 Experts pro Layer passen in 16 GB VRAM — der Rest rechnet auf der CPU. Zum Vergleich: RTX 3060 12 GB hält 37 von 256 Experts pro Layer in VRAM und schafft 58–60 tok/s Decode und ~2 000 tok/s Prompt-Prefill. Die 4080 Super hat deutlich mehr VRAM und Bandbreite → realistisch deutlich über 60 tok/s (Schätzung, kein gemessener Wert für diese Karte).
- Bilder: unter 24 GB VRAM läuft der Encoder auf der CPU — ca. 1–2 s pro Bild, keine VRAM. Funktioniert auch parallel und mit dem Gesprächscache.
- Parallele Requests: hier geht bis zu 8 (
--parallel N), anders als bei Flash-Next. Auf einer 16-GB-Karte im Hybrid-Modus bietet Setup aber nur 2 Slots bei 32K Kontext an, weil jeder Slot ~1,5 GB VRAM für den Cache frisst und den Experts den Platz wegnimmt. - Kein 29-GB-N-Gram-Table nötig — die braucht nur Flash-Next. Der Download bleibt also bei ~24 GB statt 66–76 GB, und das Laden dauert Sekunden statt 1–3 Minuten.
### Grenze, die man kennen sollte
logit_biaswird auf diesem Engine-Pfad nicht unterstützt — der Server lehnt Requests damit ab.- Qualitativ ist es ein 35B-A3B-Modell, also eine Klasse unter Qwen3.8-Flash-Next (125B). Der Vorteil: es passt komplett in 32 GB RAM, ohne SSD-Paging, und ist dadurch deutlich schneller und alltagstauglicher.
Fazit für den Freund: Qwen3.6-35B-A3B UD-Q4_K_XL ist auf 32 GB RAM + 16 GB VRAM die entspannteste Wahl. Wenn es primär um Coding geht, ist der Flash-Next-Coder (29,6 GB Shard 1) die qualitativ bessere Alternative — aber enger im RAM und langsamer.
Hier der links zum Git.hub:
## Ja, genau das ist die Seite
https://github.com/Niko1221/Strata/blob/main/docs/QWEN36.md — das ist die Detailseite zu Qwen3.6-35B-A3B, aus der ich die Angaben habe (Hybrid-Modus auf 12/16 GB,
--parallel, Bild-Reader, die 58–60 tok/s auf der RTX 3060, logit_bias-Grenze).
SheepShaver
Commodore
- Registriert
- Nov. 2004
- Beiträge
- 4.986
Ah, dann sind das zwei verschiedene Baustellen.nutrix schrieb:Gar keiner. Der erste Prompt beim Chat funktioniert immer, der 2. mal gelegentlich, und danach bleibt es hängen, egal was ich mache. Es bleibt bei "Gedanke" hängen. Ich verwende v1
Anhang anzeigen 1771786
Die Parameter habe ich auch mit Gemini Abo mehrfach durchgeprüft. Chat-Antwort streamen deaktivieren hilft mal, mal nicht
Anhang anzeigen 1771787
Als Startparameter verwende ich
Code::: 3. Server mit Modell (Teil 1 von 3), N-Gram-Volume und Prefix-Cache starten "%INFERNIX_EXE%" ^ "%MODEL_DIR%\Qwen3.8-Flash-Next-NVIDIA-NVFP4-Dense8-Infernix-00001-of-00003.infernix" ^ --ngram-volume "%MODEL_DIR%\Qwen3.8-Flash-Next-NVIDIA-NVFP4-Infernix.ngram" ^ --kv-dtype int8 ^ --prefix-cache-file "%MODEL_DIR%\prefix_cache.bin" ^ --host 127.0.0.1 ^ --vision ^ --port 8080
Mit PyGPT habe ich genau das gleiche Problem. Erste Prompt geht durch, beim 2. kommt
Hier habe ich mit KI auch schon alles durchprobiert, Problem ist Kontext-Speicher (Use context (memory)) und LlamaIndex mit dem message_name als Metainfo. Es ist egal, ob ich die Felder in der json-Config-Datei ausfülle oder leer lasse.Code:Error code: 400 - {'error': {'code': 'message_name_not_supported', 'message': "a non-empty message name changes participant identity, which Infernix's chat template cannot represent", 'param': 'messages', 'type': 'invalid_request_error'}}
Mit dem nackten Prompt über eine Powershell-Datei, auch mit Hilfe KI geschrieben, geht alles einwandfrei.
PyGPT: der 400er ist kein Verbindungsproblem, Infernix lehnt das name-Feld in den Messages ab, und LlamaIndex hängt das bei aktivem Kontext dran. Deshalb geht der erste Prompt durch und der zweite nicht. Entweder PyGPT in einem Modus ohne LlamaIndex, ein Proxy der name rauswirft, oder ein Issue bei Infernix aufmachen.
Das Hängen bei “Gedanke”: dein Skript schickt vermutlich nur den nackten Prompt ohne History, und genau da fängt es an zu haken. Schick doch mal manuell einen zweiten Request mit History ohne Streaming und guck, was die Server-Konsole dabei ausgibt. Außerdem würde ich einmal ohne --prefix-cache-file starten und --reasoning-loop testen.