Du verwendest einen veralteten Browser. Es ist möglich, dass diese oder andere Websites nicht korrekt angezeigt werden.
Du solltest ein Upgrade durchführen oder einen alternativen Browser verwenden.
Du solltest ein Upgrade durchführen oder einen alternativen Browser verwenden.
News LogicFolding: Huawei erreicht mit Stapeltechnik erste Ziele für neuen Kirin-Chip

peru3232
Lieutenant
- Registriert
- Mai 2011
- Beiträge
- 887
ich hab mich doch mit diesem "Werbespruch" rein auf die Aussaqge von [F]L4SH bezogen, der meinte es ist ein Taschenspielertrick... daher auch andere zweifelhafte Aussagen angereiht, die eben dazu passen.ETI1120 schrieb:Wieso sollten sie diesen Trick hassen?
ja werden sie - aber warum sind "wir" dann im Arsch? Sie sind doch bereits in vielen Gebieten meilenweit vor allen anderen, was stört Dich dabei?Ra9n@R0Ck schrieb:Ich sehe es schon kommen... China kann bald EUV + LogicFolding.
Dann sind wir im Arsch.
Das ist doch Quark. Da wird seit Jahren dran geforscht und steht in jeder Roadmap. Nennt nur keiner außerhalb Chinas Logic folding.Ra9n@R0Ck schrieb:Über LogicFolding hat hier noch keiner ernsthaft drüber nachgedacht, weil nicht nötig gewesen. Das wird uns sehr teuer zu stehen kommen

0x8100
Fleet Admiral
- Registriert
- Okt. 2015
- Beiträge
- 12.167
https://en.wikipedia.org/wiki/Three-dimensional_integrated_circuitRa9n@R0Ck schrieb:So eine Entwicklung dauert Jahre...
Das ist Unsinn.Ra9n@R0Ck schrieb:Über LogicFolding hat hier noch keiner ernsthaft drüber nachgedacht, weil nicht nötig gewesen.
- Darüber wird natürlich nachgedacht. Und zwar schon seit ziemlich langer Zeit.
- Es ist notwendig, weil die Skalierung neuer Nodes nur noch sehr bescheiden ist. Wenn die Devices größer werden, werden die Signalwege zu lang. Was die Performance beeinträchtigt und die Power nach oben treibt.
- Weil spätestens mit CFET auch die Logik selbst in zwei Ebenen hergestellt wird
"Cross-Disciplinary Innovations Required for the Future of Computing", Sam Naffziger, AMD, SkyTalk, DAC 2021
Dazu gibt es in den letzten Jahren stapelweise Patentanträge. Ich denke auch von anderen.
Hinzu kommen alle X3D Chips, die MI300, MI350 und die MI450.
Was Huawei zusätzlich verwendet hat ist die Face to Face Anordnung, was defakto bewirkt, dass beide Chips zu einem Chip mit der doppelten Fläche stehen. Bei der Face to Back Anordnung werden beide Chips über TSVs verbunden, was einen Tick schlechter ist.

Land_Kind
Lt. Commander
- Registriert
- Jan. 2013
- Beiträge
- 1.161
Ich hatte mal ein Huawei P30 Pro, welches einen HiSilicon Kirin 980 als CPU hatte. Mit dem Handy war ich ehrlich gesagt sehr zufrieden.
Handys können sie also bauen. Jedenfalls besser als Autos, wie bsp. dem Luxusvan Maextro V800. Bei dem sind bei Bremstests bei drei (3) Modellen die Bremspedale gebrochen. Das ist leider nicht einfach nur peinlich...
Handys können sie also bauen. Jedenfalls besser als Autos, wie bsp. dem Luxusvan Maextro V800. Bei dem sind bei Bremstests bei drei (3) Modellen die Bremspedale gebrochen. Das ist leider nicht einfach nur peinlich...
Zuletzt bearbeitet:
Schöne, bunte Bilder!ETI1120 schrieb:Das ist Unsinn.
- Darüber wird natürlich nachgedacht. Und zwar schon seit ziemlich langer Zeit.
- Es ist notwendig, weil die Skalierung neuer Nodes nur noch sehr bescheiden ist. Wenn die Devices größer werden, werden die Signalwege zu lang. Was die Performance beeinträchtigt und die Power nach oben treibt.
- Weil spätestens mit CFET auch die Logik selbst in zwei Ebenen hergestellt wird
Anhang anzeigen 1768990
"Cross-Disciplinary Innovations Required for the Future of Computing", Sam Naffziger, AMD, SkyTalk, DAC 2021
Dazu gibt es in den letzten Jahren stapelweise Patentanträge. Ich denke auch von anderen.
Hinzu kommen alle X3D Chips, die MI300, MI350 und die MI450.
Was Huawei zusätzlich verwendet hat ist die Face to Face Anordnung, was defakto bewirkt, dass beide Chips zu einem Chip mit der doppelten Fläche stehen. Bei der Face to Back Anordnung werden beide Chips über TSVs verbunden, was einen Tick schlechter ist.
Was Huawei da macht, ist schon deutlich fortgeschrittener als aktuelle TSV Prozesse.
Und NAND mit Logik zu vergleichen, ist sehr spannend 😅....
@Ra9n@R0Ck Du hast behauptet keiner denkt darüber nach, und das ist Unsinn.
Du kennst die Definition von R&D? Ist das Gegenteil von im produktiven Einsatz. Man setzt es dann ein, wenn es technisch möglich und wirtschaftlich sinnvoll ist.Ra9n@R0Ck schrieb:Zeig mal, wo. Und schon im produktiven Einsatz?
So eine Entwicklung dauert Jahre...
Die AMD Slide wurde oben ja schon gepostet. Das geht noch viel weiter als das was Huawei gerade macht.
Die Fertigungstechnik ist verfügbar. Es ist die gleiche, die bei AMDs x3D Cache eingesetzt wurde, nur dass man beim Chip-Design einen Schritt weiter geht. Anstatt nur den L3 Cache auslagert geht man einen Schritt weiter und nimmt weitere Blöcke oder Teile von Blöcken hinzu: L2, L1 Cache IO, und Logic die nicht so hoch taktet wie CPU und GPU und weniger Hotspots bildet.
Hier mal ein Bild:
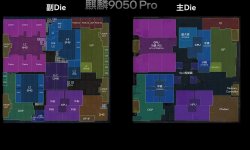
Man sieht in dem Video von Geekerwan auch, was noch Probleme sind. Man erreicht nicht die Dichte wie bei einem einzelnen Die. Man bekommt that eine weitere Dimension hinzu. Dazu kommen dann noch thermische Aspekte.
Mit beiden Dies ist der Kirin 9050 240 mm2 groß. Das ist 50% mehr als ein Apple M5. Aber Performance-technisch versucht man mit den A-SoC zu konkurrieren.
Das zeigt die Problemarik. Es ist eine sehr imposante aber auch sehr teure Technik. Deswegen wird es noch nicht breiter eingesetzt und wohl auch bei Huawei eher homöopathisch. Wird nur in einem einzigen Gerät der Serie eingesetzt.
Bei Apple könnte ich mir am ehesten vorstellen, dass sie auch das großflächig bringen. Herstellungskosten sind bei Apple weniger problematisch als bei Qualcomm/Mediatek und das Scaling in 2D nimmt immer weiter ab.
Bei anderen Produkten ist es schwieriger. Mobile SoC haben den deutlich besseren Split an Memory, IO, LP Logik zu HP Logik im Vergleich zu reinen CPUs oder GPUs.
Zuletzt bearbeitet:
Ähnliche Themen

- Antworten
- 27
- Aufrufe
- 7.437

- Antworten
- 7
- Aufrufe
- 4.013