QNAP TS-251 (RAID 1): Current Pending Sector auf HDD 2 steigt – tauschen oder beobachten?

MeRida

Ensign
Registriert
März 2008
Beiträge
230
Hallo zusammen,

mein QNAP-NAS meldet seit heute Nacht SMART-Warnungen auf einer der beiden Platten und ich hätte gerne eure Einschätzung, bevor ich etwas falsch mache.

System
  • QNAP TS-251+, QTS 5.2.10
  • 2x 4 TB im RAID1, Belegung ca. 2,86 TB
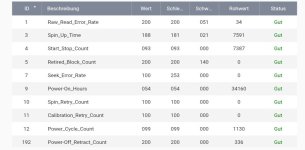
  • Platten: WD40EFRX-68WT0N0, Betriebsstunden (ID 9): HDD 1 34161 h / HDD 2 34160 h
  • NAS läuft nicht 24/7, sondern täglich ca. 15–23 Uhr (Energiezeitplan), daher 1130 Power Cycles

Verlauf
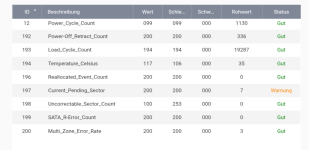
  • Heute Nacht: QTS meldet Warnung für HDD 2, ID 197 (Current_Pending_Sector) Rohwert 2
  • Ca. 08:00: Mail "SMART-Status hat sich normalisiert", 197 wieder 0
  • Kurz darauf: 197 auf Rohwert 7 gestiegen, zusätzlich wurden mehrere fehlerhafte Blöcke erkannt
  • Vollständiger SMART-Test lief parallel auf beiden Platten

Aktuelle SMART-Werte HDD 2
  • 5 / 196 Reallocated: 0
  • 197 Current_Pending_Sector: 7
  • 198 Uncorrectable_Sector_Count: 0
  • 199 UDMA_CRC_Error_Count: 0
  • 193 Load_Cycle_Count: 19287
  • Temperatur: 39 °C
HDD 1 ist bisher unauffällig. Screenshots der SMART-Tabellen hänge ich an.

Backup-Situation
  • Wichtige Daten gehen täglich per HBS3 auf OneDrive
  • Vollsicherung per HBS3 auf eine externe WD MyBook 4 TB (USB) einmal die Woche

Meine Fragen
1. Würdet ihr bei diesem Verlauf sofort tauschen oder erst noch beobachten?
2. Beide Platten sind gleich alt. Würdet ihr HDD 1 direkt mit tauschen bzw. zeitnah hinterher?
3. Lohnt es sich, direkt auf 2x 8 TB zu gehen (erst HDD 2, später HDD 1, dann Volume erweitern), oder gibt es beim TS-251 dabei Stolperfallen?
4. Kann ich sonst irgendwas tun?

Danke vorab für eure Einschätzungen!
 

Anhänge

  • Screenshot_20260927-102138~2.jpg
    Screenshot_20260927-102138~2.jpg
    51,8 KB · Aufrufe: 44
  • Screenshot_20260927-102143.png
    Screenshot_20260927-102143.png
    97,8 KB · Aufrufe: 48
Bei einem NAS würde ich keine Kompromisse eingehen, auch wenn es im Moment etwas schmerzhaft ist eine neue HDD zu kaufen. Auf jeden Fall typgleiche und herstellergleiche kaufen.
  • HDD ersetzen und alte HDD eventuell in externem Gehäuse weiternutzen für unwichtige Daten.
 
Tauschen. Raw Read Error Rate ist größer 0, was bei WD nicht normal ist (nur Seagate darf da komische Werte anzeigen). Pending Sektoren sind an sich normal, die HDD hat noch nicht entschieden, ob die defekt sind oder nicht. Wenn Defekt, dass geht Reallocated hoch. An sich auch nicht wild. Die HDD macht was sie soll. Aber du hast auch Multi Zone Errors... Wegen denen und der Raw Read Error Rate würde ich die Platte zeitnah tauschen.
 
  • Gefällt mir
Reaktionen: feris
Wie kritisch ist es denn das NAS in diesem Zeitraum laufen zu haben?
Bspw. wie hoch wären eure finanziellen Verluste, wenn es an 2 Tagen nicht laufen würde?
Davon ausgehend ggf. überlegen einfach nur 1 Festplatte ohne RAID zu nutzen, wenn die permanente Verfügbarkeit nicht so arg wichtig ist.

Damit sparst du dir den aktuell teuren Neukauf und wenn die Festplatte mal ausfällt, bestellst du per Express eine neue und spielst das Backup ein. Nach 2 Tagen läuft auch wieder alles wie vorher.
 
Gerade ist der Bad Block Scan der ersten HDD auch fertig geworden. Die fängt nun ebenfalls mit ID 197 Warnings an :(

Hier die SMART-Werte der HDD 1:

1790500286713.png

1790500304053.png
 
Tauschen. Und bedenken: Bis die neue Platte da ist, und bis der Rebuild fertig ist, kann auch die 2. Platte sterben. Dann war es das, mit deinen Daten. Das Zauberwort heißt also, trotz Spiegelung, BACKUP.
 
  • Gefällt mir
Reaktionen: feris
Zumindest ist bei 198 noch alles gut. Aber ja, die Platten sollten ausgetauscht werden. Es gab auf beiden mehrfach Probleme, Sektoren zu lesen. Bei Attribut 200 gab es ebenfalls Fehler - also auch bei Schreibversuchen.

MeRida schrieb:
Lohnt es sich, direkt auf 2x 8 TB zu gehen (erst HDD 2, später HDD 1, dann Volume erweitern), oder gibt es beim TS-251 dabei Stolperfallen?

In der aktuellen Zeit würde ich mir wohl zwei WD Elements oder MyBook mit 8TB kaufen und die ausbauen. Das ist ein deutlich besserer Deal als zwei interne mit 4TB und externe mit 4TB brauchste nicht kaufen, die haben SMR.
 
floklo4 schrieb:
Pending Sektoren sind an sich normal
Normal ist das nicht. Das ist in der Regel immer an Zeichen dafür, dass die Platte stirbt, wenn sie schon diese Verzögerung hat, dass die auftauchen und nicht sofort mit Reservesektoren ersetzt werden.
 
mit Pending hast du schon datenverlust der hier nur mit raid ausgeglichen werden kann, wenn es beim lesefehler bleibt. dazu muss aber das raid selber ein check durchführen und hierbei auf die fehler stossen, der smart von sich aus kann das nicht der betrachtet stets immer nur die platte einzeln für sich

bleiben die fehler bestehen kann der rebuild deswegen schief gehen
TorenAltair schrieb:
dass die auftauchen und nicht sofort mit Reservesektoren ersetzt werden
um einen reserve sektor einsetzen zu können brauchst du die daten des sektors und gerade die fehlen bei pending ja, sektor nicht mehr korrekt lesbar

ansonsten wenn du den sektor trotzdem ersetzt und die daten davon zu 000 werden hast du effekt "silent bitrot" geschaffen

und ohne weiter kontroll instanzen (dateisystem mit prüfsummen) dann keine chance mehr den fehler zu korrigieren sondern die kaputten dateien wandern auf die andere platte im raid, in dein backup, etc

die verzögerung entsteht nicht durch die platte sondern die anwendung die neue daten für den sektor schreibt (oder halt nicht)
 
kieleich schrieb:
Das ist in dem Fall nicht silent. Silent Bitrot ist das Flippen von einzelnen Bits in Datenträgern, die eben nicht bemerkt werden.
 
wenn du erwartest das da sofort eine ersetzung passiert dann ist es silent

ohne daten kann da auch nicht ersetzt werden, sonst falsche daten = bitrot

der betroffene sektor muss, solange die original daten nicht gelesen werden können, und keine neuen daten überschrieben werden, einen lesefehler liefern somit im Pending verbleiben

es ist normal das da "nicht sofort" irgend was passiert
 
kieleich schrieb:
mit Pending hast du schon datenverlust

Naja, ein schwebender Sektor heißt m.E. noch nicht sicher einen Datenverlust. Den hat man erst sicher, wenn Bad Blocks bzw. Uncorrectable Sectors vermerkt werden. Und wenn stattdessen Remapping stattfindet, weiß man sicher, dass es keinen gab.

Da müsste man jetzt nen Long Smart Scan oder so machen, um Gewissheit zu haben.

PS: Ich würde mal den Status des RAID prüfen.
 
Zuletzt bearbeitet:

Ähnliche Themen

Zurück
Oben