[Sammelthread] AI - Bildgenerierung (Stable Diffusion, Midjourney & Co)

So das machen wir jetzt einfach so. der Eine so der Andere halt anders.
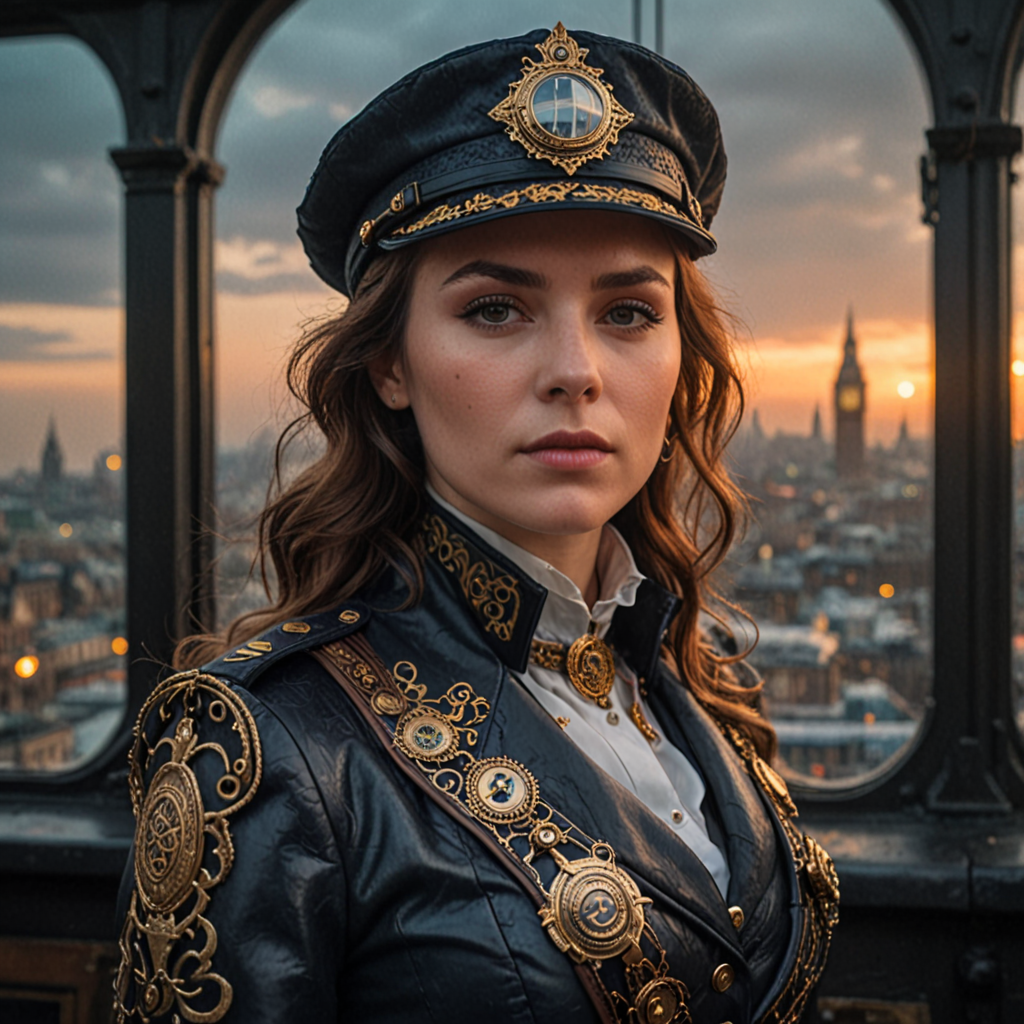
Luftschiff Kapitänin.
diffusion-895126b.png

Close-up portrait of a fierce female airship captain on the bridge. Her face is partially lit by the orange glow of gas lamps and the blue flicker of steam. She wears an ornate leather coat with gold embroidery and brass medals. In the blurred background, the sprawling steampunk city of London can be seen through a window pane covered in light condensation. Intricate details on her skin and clothing, sharp focus, cinematic bokeh, 8k, masterpiece.
 
  • Gefällt mir
Reaktionen: CountSero und RyzA
Das wird erst mal das letzte Bild sein, das ich poste, und ich erkläre auch warum. Ich arbeite oft lange am Prompt und versuche, fast alle Details festzulegen und zu arrangieren. Hierbei nutze ich auch einen Prompt Enhancer/Refiner (auf Ollama-Backend), wofür ich über Wochen System-Prompts entworfen und verfeinert habe. Ich erstelle dann das erste Bild und lasse evtl mal den Refiner drüber laufen, dann das zweite, dritte und so weiter, bis ich zufrieden bin. In der Zeit ändere ich immer eine Sache nach der anderen. Im Schnitt habe ich vor dem finalen Bild ca. 15 bis 20 Prompt-Änderungen vorgenommen und somit auch gerendert, bevor ich evtl. zufrieden mit dem Bild bin.

Ich mache das gerne, aber es entsteht halt eine Wall of Text in Form eines Prompts, im Schnitt sowas um die 300 - 400 Wörter.

Das Bild, das ich anhänge, hat einen Prompt von 455 Wörtern und dadurch einen Token-Count von ca. 623.

Bei KREA2 sollte man normal im Rahmen von 512 Token bleiben, somit bin ich hier schon argh über der Grenze und es gibt schon etwas Prompt Bleeding, dennoch bin ich mit dem Ergebnis zufrieden.

Aber ich möchte halt nicht immer eine Wall of Text unter jedem Bild posten, und da es nun mal die Vorgaben sind, wird dies das letzte Bild sein.

Also zum Schluß eine kleine Cosy Scene mit Meme-Anspielung ;) Na, wer erkennt es?

song_name.webp


Das Bild wurde mit "KREA2 turbo fp8 scaled" mittels ComfyUI erstellt und das ist der Prompt:

Epic wide-angle full-body photorealistic interior shot of a 45-year-old Irish woman with a soft hourglass silhouette and highly defined abdominal muscle separation creating crisp visible lines across her midriff, striking emerald green eyes now softly closed, vibrant red hair swept into a loose messy bun pinned with a small golden hair clip, a delicate golden septum hoop piercing her nose, and a faint peaceful smile on her lips. She reclines fully barefoot on a sleek designer black leather chaise longue with a polished chrome frame, one arm draped casually behind her head, the other resting flat against her stomach, torso relaxed and slightly arched against the curved leather seat. She wears a pristine white silk tailored suit, the jacket unbuttoned revealing the fine silk lining,the smooth cotton of the inner shirt and a silk zipper shirt with golden zippers, the trousers falling naturally with soft fabric draping over her hips and thighs, the silk catching subtle highlights from the ambient light. She wears high-end designer over-ear headphones resting on her head, a long cable trailing behind her across the floor toward a distant hi-fi shelf, connectet to the amplifier. On the polished black-and-white marble floor, her emerald-green stilettos lie discarded beside the chaise longue, the sharp Italian leather catching reflections from the glossy stone. beside the chaise longue, a small glass side table holds a tumbler of iced whisky with glistening condensation on the glass. The background reveals a massive floor-to-ceiling panoramic window framing a lush green rolling landscape, while on the far horizon an enormous ominous orange sandstorm wall looms across the sky, casting a warm amber backlight across the entire room. On the far wall, a minimalist hi-fi shelf holds a premium tube amplifier with glowing warm tubes, a sleek designer turntable spinning a vinyl record, a graphic equalizer with visible frequency bars, and a small framed picture bearing bold typography reading "SONG NAME?". The black-and-white polished marble floor mirrors the entire scene in sharp crisp reflections, doubling the chaise longue, the marble patterns, and the warm orange glow from the distant storm. Photorealistic cinematic wide-angle lens, 24mm perspective, shallow depth of field with the background landscape and sandstorm slightly softening, natural volumetric lighting from the panoramic window with the orange storm providing dramatic rim backlight and warm atmospheric haze, rich skin texture on her face and hands, realistic fabric behavior of the silk suit with natural gravity folds and soft creases, professional interior design lighting, 85mm macro detail on the chrome frame and glassware, high-resolution digital photography, color grading with cool marble tones contrasted against the warm orange exterior. Down in the bottom right corner of the frame, the artist signature in neon-teal stylized handwriting shows "CountSero" with a decorative stylized underline.
 
Zuletzt bearbeitet:
  • Gefällt mir
Reaktionen: RyzA und AndreasF1975
@CountSero
Schade! Ich denke man kann auch gut ohne Prompt leben. Für mich sehr interessant, dass Du ein Prompt von 455 Wörtern hast. Müsste mal meine längsten abzählen (lassen). Denke aber nicht das ich ansatzweise so viele hatte.
 
  • Gefällt mir
Reaktionen: RyzA und CountSero
Zu jedes Bild den Prompt zu Posten ist nicht immer praktikabel, gleiches gilt ja auch für Workflows. Gerade wenn es komplexer wird.
Jeder sollte das Beitragen, was er/sie als angemessen hält. Manchmal ist das Ergebnis selbst eine Art Inspiration, was man mit einem Modell erreichen kann.
Nur beizuschreiben, um welches Modell es sich handelt und welches Tool genutzt wurde wäre durchaus wünschenswert. Mehr Infos sind doch nur ein Nice to Have.

Nur meine bescheidene Meinung. "Regeln", die nicht mehr praktikabel sind, gehören gekippt.
 
  • Gefällt mir
Reaktionen: RyzA und AndreasF1975
Mal ein Bild im Comic-Style. Roter Doppeldecker der über den Wolken fliegt. Sterne und Sonne sind zu sehen.
Erstellt mit der Free Version von ChatGPT.

Roter Doppeldecker über den Sternenwolken.png
 
  • Gefällt mir
Reaktionen: AndreasF1975
Meine Experimente gehen weiter. Es ist sehr interessant wie aus einer Idee nach weiterer verfeinerung die Ergebnisse immer besser werden. Ich muss allerdings aufpassen mich nicht zu verhardern mit verschiedenen Motiven. Es schwirrt so viel in meinen Kopf und alles will sofort umgesetzt werden. So das ich derzeit an mehreren Ideen arbeite. Was natürlich nicht so toll ist wie ich merke da sich mein fokus ständig verschiebt. Auch das muss ich noch lernen.
Hier ein Zwischenergebnis. Hoffe das ich bald ein Bild zeigen kann womit ich wirklich zufrieden bin.
diffusion-446669.png
Pinokio - Uncensored Local Studio - DreamShaperXL
 
  • Gefällt mir
Reaktionen: RyzA
@CountSero Meine bitte war, anzugeben womit das Bild erstellt wurde, nicht der Prompt.
Niemand sollte gezwungen werden seinen Prompt zu veröffentlichen.
 
blubberbirne schrieb:
@CountSero Meine bitte war, anzugeben womit das Bild erstellt wurde, nicht der Prompt.
Niemand sollte gezwungen werden seinen Prompt zu veröffentlichen.


Nein liegt nicht an dir, ich habe mir gestern erst den Startpost durch gelesen dort steht:

Posting-Regeln für Bilder​

  1. Bei Bildern bitte immer (mindestens) angeben, womit und mit welchem Prompt es erstellt wurde, wie im folgenden Beispiel dargestellt. Bei mit Hilfe von "img2img" oder anders weiter bearbeiteten Bildern, gerne den Entstehungsprozess mitteilen oder mit Bildern darstellen - das kann sehr hilfreich sein.
  2. Für den Inhalt der Bilder gelten die Allgemeinen Forenregeln
 
Entweder wir ändern die Regeln, ignorieren diese oder machen einen neuen Thread auf.
diffusion-914658.png


Pinokio - Uncensored Local Studio - DreamShaperXL
Prompt auf Nachfrage
 
  • Gefällt mir
Reaktionen: CountSero
Flux.3 hat es ins Comfy geschafft!

Ach so, edit: Ich bleibe bei Z-Image Turbo. Das reicht mir mehr als. Flux 2 Image Edit jedoch war gut... hm. Ich gucke mal, was ich da so höre, bevor ich von 2 auf 3 gehe.
 
  • Gefällt mir
Reaktionen: MechanimaL
Weitere Version mit ChatGPT. Ich bin beeindruckt Aber auch sehr zufrieden was ich Lokal erreichen kann.
Maskenfigur im roten Ballonmeer.png
 
  • Gefällt mir
Reaktionen: RyzA und CountSero
Hat jemand Erfahrung mit hochauflösenden KI Nahaufnahmen. Besonders wenn es um Spiegelungen in den Augen oder anderen Objekten geht!?
Teilweise spiegelt sich ja bei richtigen Aufnahmen nicht nur der sichtbare Bereich in den Augen ab sondern auch das was hinter der "Kamera" liegt.
Ganz weird wird es wenn die Figur zb vor einem Spiegel, Fenster oder so steht.

Es geht mir nicht darum diese "Spiegelungen" zu vermeiden. Sondern eher gezielt einzusetzen um zb ein Portrait oder Foto realistischer wirken zu lassen.
Besonders bei vermeintlichen "Spontanaufnahmen" außerhalb eines Studios ohne Profifotograf oder Equipment.
 
Zu den Postingregeln:

Die sollen natürlich einen Nutzen für alle haben. Ich stimme @blubberbirne zu, dass es sinnvoll ist, zumindest das Modell zu nennen, mit dem ein Bild gemacht wurde, das ist ja auch kein großer Aufwand, aber hat für die anderen User einen deutlichen Wert.

Was den Prompt angeht, war dieser früher tatsächlich relevanter und die Angabe somit wertvoller:
  • es gab bestimmte Wörter, die Qualität bzw. bestimmte Qualitätsmerkmale getriggert haben, was heute nicht mehr in dem Maß der Fall ist
  • man konnte manche Dinge nur mit viel Mühe erreichen und musste dafür mit der möglichen max. Länge hinkommen
  • und last but not least: er war entsprechend meistens auch wesentlich kürzer ;)

Niemand muss den Prompt teilen, aber es ist eine für andere nützliche Information und von daher ist das Teilen - da wo es sinnvoll erscheint - oder auf Nachfrage, wünschenswert. Längere Prompts bitte unbedingt in einen "Spoiler" packen, damit das hier nicht unnötig aufbläht.
Wenn man zb. trotz kurzen Prompts etwas beeindruckendes erzielt, oder wenn man erst diese eine bestimmte Formulierung finden musste, um etwas zu erreichen, oder bei diesem SD1.5 Bild im Eingangsposting, das "erfundene" Wort, was zu diesem neuartigen Tier geführt hatte ;-)

Aufgrund dieser Entwicklung aktualisiere ich im Interesse aller die Regel wie folgt:

Posting-Regeln für Bilder​

  1. Bei Bildern bitte immer (mindestens) angeben, womit es erstellt wurde. Falls es sinnvoll erscheint, auch den Prompt mit angeben, wie im folgenden Beispiel dargestellt. Längere Prompts bitte mit der "Spoiler"-Funktion einklappen. Bei mit Hilfe von "img2img" oder anders weiter bearbeiteten Bildern, gerne den Entstehungsprozess mitteilen oder mit Bildern darstellen - das kann sehr hilfreich sein.
  2. Für den Inhalt der Bilder gelten die Allgemeinen Forenregeln

Zu den Inhalten:

Austausch zu allem, was mit Bilderstellung (gerne auch Bewegtbild) zu tun hat und Posten von Bildern ist momentan beides als Inhalt vorgesehen. Schließt natürlich nicht aus, dass es sich z.B. irgendwann auch lohnt einen eigenen Bilderthread zu haben, z.B. wenn das der Konsens in diesem Thread wäre, es lieber zu splitten. Das könnte dann wahrscheinlich recht leicht mit der Boardmoderation geklärt werden und die hätte (meiner Vermutung nach) nichts dagegen, dass jemand einen solchen Thread eröffnet.
 
  • Gefällt mir
Reaktionen: RyzA, AndreasF1975 und CountSero
@MechanimaL Danke fürs Update.

Und ja, auf spätestens Nachfrage werde ich auch einen Prompt teilen, wenn hier nicht gerade massiv Arbeit drin steckt. Aber da bin ich bereit zu erklären, wie ich es gemacht habe. Ich denke aber, man hat schon gesehen, dass ich generell bereit bin zu teilen, wie ich an die Sache herangehe bzw. welchen Workflow ich habe.

Da ich bequem bin, habe ich mich auch vorbereitet:

MetaInfos.webp

Ergänzung ()

Hier ein Experiment mit Action Figures:

miscellaneous  Babarian Toys -0092.webp

Bild ist entstanden mit krea2_turbo_fp8_scaled mittels ComfyUI mit folgenden Settings:
Step 1 | Auflösung: 1344x768 | seed: 1976, steps: 8, cfg: 1.0, sampler: exp_heun_2_x0_sde, scheduler: sgm_uniform, denoise: 1.0
Step 2 | Auflösung: 2016x1152 (Skaliert x1.5) | seed: 1976, steps: 8, cfg: 1.2, sampler: exp_heun_2_x0_sde, scheduler: sgm_uniform, denoise: 0.5


Epic wide-angle full-body shot of a dark castle throne room hall, an action-figure collectible diorama rendered in highly detailed PVC and plastic toy textures with a premium collector-edition aesthetic, sharp edges, glossy finish, and realistic figurine photography, composed as a cinematic tableau. In the center of the frame a massive throne carved from rough-hewn obsidian and wrapped in heavy dark animal skins, (obsidian throne:1.2), sits a 45-year-old Irish barbarian queen with a soft hourglass silhouette, (barbarian queen:1.2), striking green eyes, fierce relaxed expression with a smirky smile, red hair in a messy bun, a golden septum hoop in her nose, wearing a rustic fur bandeau top, a primitive fur loincloth, and heavy fur-trimmed boots, leaning back casually with legs slightly spread, holding the handle of a noble claymore sword in her left hand resting between her legs, (claymore sword:1.15), gazing directly at the camera with a confident, commanding look. Behind the stone throne stands a lean 30-year-old East Asian elite archer with salt-and-pepper extremely long hair braided into a single braid, wearing a fitted dark leather harness uniform, a large wooden recurve bow and a quiver of feathered arrows slung across his back, standing calm and alert in the background. To the queen's right side a young servant in an emerald green barbarian silk dress bows her head in awe, reaching forward with both hands to present a wine glass of red wine to her queen, (emerald green silk dress:1.15), her posture one of deference and reverence. At the queen's feet on the polished stone floor a raven-black direwolf rests and is gently petted by her, its sleek black fur catching the warm light, (direwolf:1.2). The background reveals a dark stone castle throne room hall with flickering torchlight casting deep dramatic shadows and warm highlights across the fur textures, the cold stone walls, and the faces of every figure, (torchlight:1.2). The scene is lit with professional studio macro lighting simulating a premium collectible figure display, with rich tactile material contrast between the glossy plastic surfaces, the rough stone, the soft fur, and the polished obsidian, cinematic composition, raw storytelling atmosphere, color grading warm amber and deep shadow contrast, wide-angle lens at 22mm focal length, shallow-to-deep depth of field keeping all figures sharp within the diorama frame, rendered as a single cohesive collectible figure photography with premium PVC and plastic toy textures and a sharp glossy finish throughout.
 
Zuletzt bearbeitet:
  • Gefällt mir
Reaktionen: Ozmog, RyzA, AndreasF1975 und eine weitere Person
Zu Deinem Post. Man sieht, dass Du Dir richtig die Mühe gemacht hast, jeden Schritt zu verstehen und dann auch selbst Workflows bauen kannst, bzw sinnvolle Modifkationen vornehmen. Das ist viel wert. Wenn ich es richtig sehe ist es im Grunde ja ein Latent Upscale Prozess im Sinne von (Früher so genannt) "Hi-Res-Fix-Uspcale": Du erzeugst ein BIld nahe der nativen Auflösung und machst dann einen latent Upscale davon. Dass dabei ein weiterer Sampler benutzt wird liegt ja bei latent Upscaling in der Natur der Sache. Du hast aber natürlich noch paar Dinge drum rumgebaut :)

Ich benutze ja SwarmUI (schon länger) und verwende einfach mal den Fall mit einem solchen Upscaling als Beispiel. Krea2 (kennt sich in manchen Bereichen ja schon ohne Hilfe gut aus ;) ):

1792101613633.png

a young woman in an overwatch gaming room wearing overwatch tracer suit.


1792102096554.png
 
  • Gefällt mir
Reaktionen: RyzA und AndreasF1975
@MechanimaL Ja, es ist in dem Sinne ein "Hires-Fix". Ich habe zwar erfolgreich auch schon nativ Bilder über 1 Megapixel gerendert, aber wenn man genau hinschaut, sind dann doch irgendwelche Anomalien irgendwo versteckt.

Auch habe ich mir die verschiedenen Frontends mal angeschaut, aber als Erstes halt ComfyUI getestet und bin dann einfach dabei geblieben. ComfyUI gefällt mir, weil man hier recht gut experimentieren, basteln und Custom Nodes einfach einbinden kann. Besonders da ich nun so viele eigene Custom Nodes nutze (Teils Vibe und Teils selbst geschrieben), werde ich wohl auch so schnell nicht mehr wechseln.

Für mich war es wichtig, es hier autodidaktisch anzugehen, eventuell ist nicht alles ganz sauber (gefährliches Halbwissen und so), aber bis jetzt bin ich gut damit gefahren. Und der Workflow ist halt absolut mein eigener.

Auch mag ich es, die Prompt-Grenze auszureizen. Das An die Grenze Gehen und das Bestimmen von Kleinigkeiten macht einfach Spaß. Es ist eben weniger Zufall und mehr Komposition ^^

Aber SwarmUI sieht intressant aus.

Hier mal dein Prompt in hochkant (müsste 4:7 sein ^^):

miscellaneous OW-0102.webp


Bild ist entstanden mit krea2_turbo_fp8_scaled mittels ComfyUI mit folgenden Settings:
Step 1 | Auflösung: 1152x2016 | seed: 1976, steps: 8, cfg: 1.0, sampler: exp_heun_2_x0_sde, scheduler: sgm_uniform, denoise: 1.0
Step 2 | Auflösung: 1728x3024 (Skaliert x1.5) | seed: 1976, steps: 8, cfg: 1.2, sampler: exp_heun_2_x0_sde, scheduler: sgm_uniform, denoise: 0.5
 
  • Gefällt mir
Reaktionen: RyzA und AndreasF1975
Prompt:

Erstelle ein episches und cinematisches Bild wo eine dunkelhaarige Kriegerin auf einen großen realistisch aussehenden Drachen reitet. Der Drache fliegt mit der Kriegerin durch die Wolkendecke. Es ist ein Sternenhimmel und auch die Sonne zu sehen.
KI: Chat GPT (Free Version)

Drachenreiterin über den Wolken.png


hier noch eine andere Version

Drachenreiterin über den Wolken (1).png


Gefällt mir schon ganz gut. Nur die Zügel noch nicht 100%.

Das dritte Bild war leider schlechter. Jetzt muss ich wieder 24 Stunden warten bis ich neue Bilder erstellen kann.
 
  • Gefällt mir
Reaktionen: CountSero und AndreasF1975
CountSero schrieb:
Hier mal dein Prompt in hochkant (müsste 4:7 sein ^^):
Fast ;)

Die Meinungen zu Flux3 Klein sind etwas gemischter Natur, positiv: klein und schnell, sowie gutes Textverständnis, dafür aber qualitativ nicht auf Augenhöhe insb. bei Details. Hat wer von Euch es schon getestet? Mal sehen, was sich da noch ergibt.

Außerdem grade erschienen: https://openmoss.ai/MOSS-Image/ - das sieht interessant aus.

Edit (besserer Link): https://github.com/OpenMOSS/MOSS-Image/tree/main

Die Tage wollte ich schonmal auf zwei Dinge hinweisen:

A) für die Nutzer von Qwen 2.1 Edit -> eine etwas verbesserte VAE, die typischen Problemen mit dem Modell in der Bildausgabe entgegenwirkt

B) eine Krea2-Steampunk LORA passend zu den Postings von Euch.
 
Zuletzt bearbeitet:
  • Gefällt mir
Reaktionen: CountSero und AndreasF1975
Kleine Zwischenfrage zu Personen/Style LoRa Training. Wie mache ich in den Dataset Bildern am besten die Gesichter unkenntlich wenn ich will das nur der Körper trainiert wird.
Einfach weichzeichnen, verpixeln, den Kopf mit nem schwarzen Loch ausstanzen!?
Oben das bild croppen fällt bei vielen weg wegen der Bildkomposition.
 
  • Gefällt mir
Reaktionen: AndreasF1975
Zurück
Oben