[Sammelthread] AI - Bildgenerierung (Stable Diffusion, Midjourney & Co)

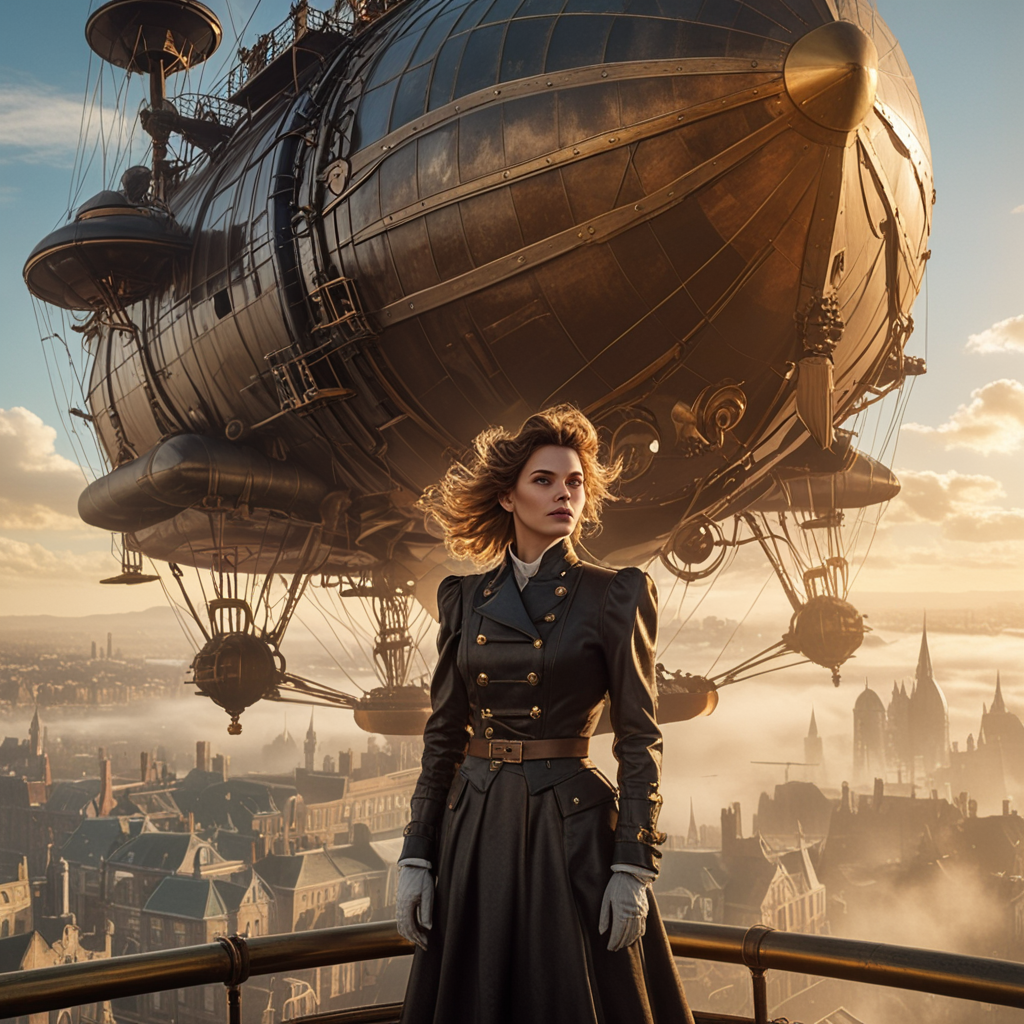
Bin gerade noch bei Steampunk.
diffusion-190973-1.png

A breathtaking cinematic shot of a female airship captain standing on an open-air navigation platform outside the hull of a massive steampunk dirigible. She is positioned at an exterior steering station made of polished brass and heavy iron levers. Her hair and her long, weathered leather coat are whipping in the wind. In front of her, a sprawling Victorian London-inspired city stretches out below under a layer of thick fog and golden sunlight. The airship's huge propellers and steam pipes are visible behind her. Dramatic perspective, high altitude, hyper-realistic, 8k resolution, masterpiece, volumetric lighting
 
  • Gefällt mir
Reaktionen: CountSero und RyzA
Schielt die Dame!?👀🤪
 
  • Gefällt mir
Reaktionen: AndreasF1975
Aus gegebenen Anlass

1791921136165.png
 
  • Gefällt mir
Reaktionen: CountSero, Ozmog und AndreasF1975
samuelclemens schrieb:
Schielt die Dame!?👀🤪

Da hilft es einfach das Gesicht nochmal einzeln nachzeichen zu lassen, das sollte in so gut jedem Tool möglich sein (inpainting eines kleineren Bereichs in voller Auflösung).
 
  • Gefällt mir
Reaktionen: AndreasF1975
@MechanimaL Ist es mit ComfyUi erstellt? Dann kannst das Bild einfach nochmal reinschieben mit metadaten und den seed locken. Im Prompt dann die Augen nachbessern aber den Rest des Prompts so belassen.
 
  • Gefällt mir
Reaktionen: AndreasF1975
@braindamage10k Dystopian Cyberpunk mixed mit Wasteland hat was, Evtl muss ich auch mehr Dreck bei meinem rein werfen^^

CyberPunk eher Richtung Gibson

miscellaneous CyberPunk Gibyson Style-0047.webp


Und einmal Tarot im SteamPunk Style

miscellaneous SteamPunk-0009.webp


samuelclemens schrieb:
Die ganze Idee mit der Verkettung ist auch komplizierter als zunächst gedacht.
Auch hier müsste man eine LLM einbauen die das prompten übernimmt.
Sonst kann man sich den Murks gleich sparen und jedes Szenenbild manuell einzeln generieren.
Ich nutze in meinem Workflow auch eine Ollama-Backend-Node. Damit kann ich nach Bedarf Prompts anpassen, umarbeiten und Bilder beschreiben. Wenn man das mit einem Image-Edit-Workflow verbindet, bei dem man eine Custom-Image-Loader-Node hat, die jeweils das zuletzt generierte Bild lädt, könnte ich mir vorstellen, dass das bei einem Batch-Run funktionieren könnte.

Um dein Beispiel aufzugreifen "Describe the image in high details and add an additional cookie to the plate."

Wenn dann immer das neueste Bild aus dem Verzeichnis geladen wird, wäre ja immer ein Keks mehr drauf " in der Theorie". Aber nur wenn das gewählte Modell auch richtig zählen kann ^^

Die Frage ist auch, ob man eine Custom Node bauen kann oder bereits gibt, die das jeweils zuletzt generierte Bild automatisch einliest.

Aber auch wenn bezweifle ich stark, dass das über einen Batch-Run hinweg wirklich konsistent die Bilder gewünscht generiert.
 
  • Gefällt mir
Reaktionen: RyzA und AndreasF1975
CountSero schrieb:
Aber auch wenn bezweifle ich stark, dass das über einen Batch-Run hinweg wirklich konsistent die Bilder gewünscht generiert.
Das funktioniert noch nicht einmal sauber wenn ich es manuell ohne batchverarbeitung mache, nur viermal hintereinander verketten mit selben prompt. In qwen Image edit ist spätestens nach dem 4ten Keks Schluss. Dann gibt's keine zusätzlichen Kekse mehr.😒
Aber war trotzdem interessant wie die KI wirklich nichts am bestehenden Bild geändert hat als einfach noch nen zusätzlichen Keks draufzulegen.

Man müsste mal testen ob das ein generelles Problem mit dem zählen oder Bildanalyse ist oder sich nur innerhalb eines Workflows äusert.🤔
 
  • Gefällt mir
Reaktionen: AndreasF1975 und CountSero
samuelclemens schrieb:
Man müsste mal testen ob das ein generelles Problem mit dem zählen oder Bildanalyse ist oder sich nur innerhalb eines Workflows äusert.🤔

Ok ich habe mal das In meinem AI Prompter gejagt:

"
Create an epic multiframe shot, photorealistic

in the first frame there is an empty plate, in the second frame there is the same plate with one cookie, in the the third frame is the same plate with 2 cookies and so on, every frame has one cookie more then the frame before."


Das kam dabei raus ^^

"epic photorealistic multi-frame food photography composite, a single image divided into a clean horizontal sequence of six identical panels showing the progressive building of a cookie platter, each panel framed identically from a direct overhead camera angle, frame one shows an empty round white ceramic plate with a subtle rim glaze resting on a dark matte black slate table, frame two shows the same plate with a single golden-brown chocolate chip cookie centered on the surface, frame three shows the same plate with two cookies placed side by side, frame four shows the same plate with three cookies arranged in a small cluster, frame five shows the same plate with five cookies filling the surface in a casual overlapping pile, frame six shows the same plate fully loaded with a generous mound of a dozen cookies heaped and stacked in a slightly disordered pile, every frame lit by a single warm overhead softbox creating a tight pool of amber light that falls off into deep shadow at the plate rim, the cookies are thick and domed with visible cracked tops, melted chocolate chip fragments glistening in the craters, golden-brown baked edges with a matte crumbly interior exposed at the fracture lines, faint flour dusting the dark slate surface, shallow depth of field keeping the plate and cookies tack-sharp while the background falls into a soft black void, cinematic high-contrast food photography in the style of a ***** or ****, 85mm lens, f/2.8, color-graded with deep blacks and warm amber highlights, no text or labels, clean composite layout with thin dark gutters separating each frame, the overall composition reads as a single epic progression from emptiness to abundance."


Schon bei einem Bild verzählt die AI sich oder ich gebe der AI zuviel kreative Freiheiten ^^

Aber mein Model bringt es auch nicht wirklich konsequent ins Bild ^^
miscellaneous Cookie Test-0050.webp


Hier sind dann also zwei Spezialisten am werk gewesen ^^

[UpDate]

Also mit meiner Node habe ich mal die Tokens geprüft sind 379 bei 280 Worten also mehr als im grünen Bereich von KREA2
 
Zuletzt bearbeitet:
  • Gefällt mir
Reaktionen: RyzA und AndreasF1975
Es ging mir ja ursprünglich nicht darum ein Bild zu erstellen sondern eine Serie zusammenhängender aber logisch aufbauender Einzelbilder.

Wie das Beispiel mit dem Ladenüberfall und dem anschließenden Unfall auf der Flucht.
Das LLM erstellt mir für diese "Handlung" zb 10 Einzelprompts/Szenen die dann vom Bildgenerator abgearbeitet werden wobei dann entweder ein oder sogar alle vorherigen Bilder als Referenz verwendet werden.
Letzeres weiss ich nichtmal ob das so möglich ist.

Das Problem mit dem Keks scheint bei meinen Versuchen mit dem Seed zusammenzuhängen glaube ich.
Wen nam ndas eben generierte Bild wieder einschiebt als referenz wird der exakte Seed für das nächste mit übernommen.
 
  • Gefällt mir
Reaktionen: AndreasF1975
Man man sich für die Zukunft eventuell darauf einigen anzugeben wie die Bilder Generiert wurden?
Also z.B. Comfyui mit Model XY, ChatGPT etc.
 
  • Gefällt mir
Reaktionen: AndreasF1975 und Vigilant
+1

Finde die inhaltlich, technische Diskussion hier auch wesentlich Interessanter als das sinnbefreite posten immer neuer Bilder ohne Kontext.
 
  • Gefällt mir
Reaktionen: AndreasF1975
Na es sollte ja schon wenn ich den ersten Beitrag lese der Prompt angegeben werden.
 
So, ich habe meinen Post, in dem ich meinen Workflow erklärt habe und welche kleinen Unterschiede ein Latent Upscale by macht, aktualisiert. Ich habe hier noch drei Bilder ergänzt, bei denen ich nativ auf 2016x1152 in 8, 14 und 22 Steps mit KREA2 Turbo FP8 gerendert habe.

Die Bilder zeigen aber gut, dass ich lieber die ersten 14 Steps in kleiner Auflösung rendere und dann noch mal nach dem Upscale weitere Steps dranhänge.

Es zeigt gut, dass KREA2 hier bei Overstepping schnell mal Schweiß, Feuchtigkeit oder Highlights aus allen Ecken zaubert.

Auch habe ich den Post um den verwendeten Prompt ergänzt, aber der ist eher für KREA2 geeignet. Und es hängt natürlich vom verwendeten CLIP Text Interpreter ab, den man verwendet, ob das Ergebnis was wird.

Dann noch ein Bild, das ich mit GPT (Luna?) bei Duck.ai erstellt habe (man hat da ein kostenloses Kontingent pro Tag, für das man keinen Account braucht). Hier habe ich denselben Prompt verwendet.

Auch eine kleinen Erfahrungsbericht was ich über KREA2 so gelernt habe.
 
  • Gefällt mir
Reaktionen: AndreasF1975
Vigilant schrieb:
+1

Finde die inhaltlich, technische Diskussion hier auch wesentlich Interessanter als das sinnbefreite posten immer neuer Bilder ohne Kontext.
Die Bilder haben ja einen Kontext. Sie haben eine Kurzbeschreibung oder Prompt.
Aber gut wenn hier von den einzelnen (lokalen) KIs alle Arbeitsschritte gepostet werden bin ich hier wieder raus. Das wird mir zu aufwändig und kompliziert.

Aber ich gucke mir gerne zwischendurch mal an was die anderen so posten. ;)
 
Zuletzt bearbeitet:
  • Gefällt mir
Reaktionen: AndreasF1975
@RyzA Nein Du bleibst schön hier. Ich will weiter Deine Bilder sehen.
 
  • Gefällt mir
Reaktionen: CountSero und RyzA
RyzA schrieb:
Die Bilder haben ja einen Kontext. Sie haben eine Kurzbeschreibung oder Prompt.
Aber gut wenn hier von den einzelnen (lokalen) KIs alle Arbeitsschritte gepostet werden bin ich hier wieder raus. Das wird mir zu aufwändig und kompliziert.

Aber ich gucke mir gerne zwischendurch mal an was die anderen so posten. ;)
Ich habe schon befürchtet, dass so etwas passiert. Ich habe echt versucht, das abzuwägen, bevor ich meinen Post verfasst habe: „Soll ich den Post verfassen oder nicht?“ :(

Also bitte nicht zurück ziehen, dann lasse ich meine Posts lieber von einem Mod ins Aquarium verschieben, wenn diese stören.

Ich finde deine Bilder \ Kompositionen auch sehr gut, da ziehe ich mich lieber zurück.

Für mich liegt auch eher der Reiz darin, so etwas selber nachzubauen oder mit dem eigenen Visual Prompter ein Bild zu analysieren und zu verstehen. Deshalb brauche ich auch keinen "Custom Workflow" oder den zugehörigen Prompt.

Auch wollte ich hier keine Unruhe reinbringen.

Von daher ein dickes Sorry an alle hier.
 
@CountSero
Nein auch Du bleibst hier. Deine Beiträge sind sehr informativ und auch lehrreich.
Ich denke hier kann jeder im Thread sein Ding finden und auch machen. Hört mit dem Kinderkram
auf und zeigt eure Arbeiten, erklärt Eure Arbeitsweise und zeigt neue Erkenntnisse auf wie Ki Arbeitet.
 
  • Gefällt mir
Reaktionen: RyzA
@CountSero : Du hast alles richtig gemacht. Es gibt wohl Vorgaben im Thread.
Die hatte ich nicht gesehen.
Also mach bitte weiter... interessant ist es ja. ;)

Nur ich mag es im Moment lieber einfach. Und dachte man kann frei weg Bilder posten.
 
Du hast noch mehr dazu geschrieben. Das ist doch ok!

Ich bin neu und habe ich mich anzupassen an die Vorgaben/Regeln. Alles gut!

Mach ruhig weiter so wie bisher. Schönen Abend noch! :smokin:
 
Zurück
Oben