[Sammelthread] AI - Bildgenerierung (Stable Diffusion, Midjourney & Co)

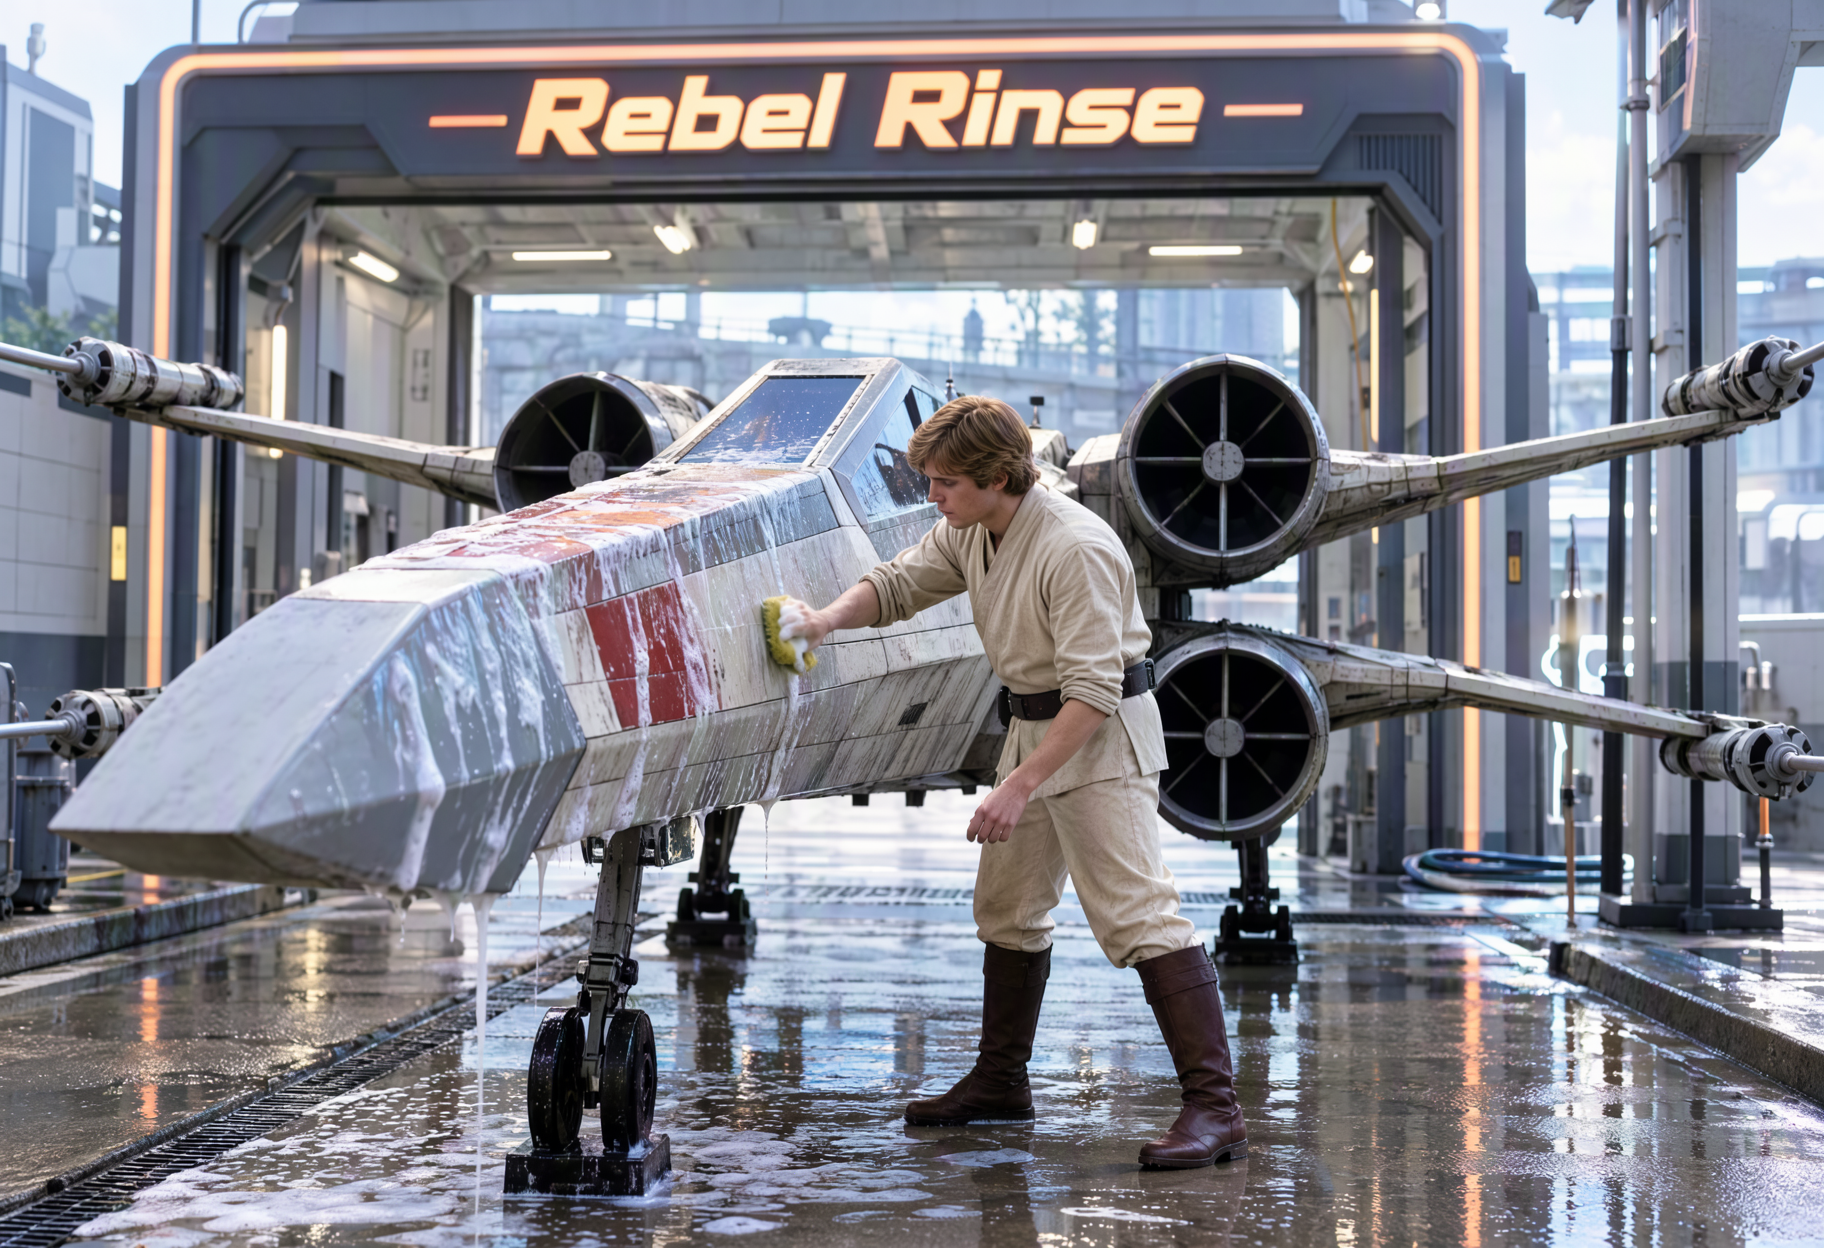
MOSS Image (sft) (ohne Turbo)
1792617198994.png

A cinematic wide shot of Luke Skywalker at a futuristic carwash, meticulously washing a weathered X-wing fighter. The x-wing fighter sits in the front of the carwash, it's wings open in the X shape. Luke is focused on scrubbing the hull of the starfighter with a sponge and soapy water, with iridescent soap suds clinging to the white and grey plating of the ship. In the background, a large, stylized neon sign prominently displays the text "Rebel Rinse" in a bold, sci-fi font. The setting is a bright, industrial wash bay with wet concrete floors reflecting the overhead fluorescent lighting and the glow of the sign. The composition captures the scale of the X-wing within the bay, blending the mundane activity of a carwash with the high-tech aesthetic of the Star Wars universe.
 
  • Gefällt mir
Reaktionen: AndreasF1975, samuelclemens und CountSero
@MechanimaL hast du mal die restlichen Setting ? weil ich komme nicht annähernd an die Qualität ^^ Von daher würde ich das gerne mal mit den 1:1 Settings testen ^^
 
@MechanimaL Stimmen die Größenverhältnisse so. Mir erscheint Luke etwas zu groß für das Cockpit.
Ist es eigentlich gewollt das der Luke dem Original kein bisschen ähnlich sieht?
Ich finde es erstaunlich wie gut die Modelle inzwischen mit der Physik von fluiden Stoffen zurechtkommen
Neulich hab ich in nem Test mit Minimax H3 jemandem Eimer Flüssigschokolade übergekippt und halbe Stunde lang erfolglos nach Fehlern ausschau gehalten.
Mit Wasser ist es aber noch n Level schwieriger weil da ja Reflexionen und Spiegelungen mit reinspielen.
Achja, bei SW ruhig immer etwas dirty mit reinbauen. Die Anlage sieht etwas zu Clean aus. Sind ja schließlich nicht bei Star Trek!🙄
 
ehrlich gesagt, ja das dachte ich auch, aber der x-wing fighter war meistens eher zu klein, auf den bildern, halt die anfänger version ;) (er sollte aber in den rein passen) und dass luke im prompt stand, hab ich auch erst später gesehen, weil - ja sieht halt nicht so aus, wie er. aber wenn man den prompt nicht kennt, kann es ja ein x-beliebiger pilot sein, aber in passender kleidung.
Es kennt ihn nicht oder man muss es noch irgendwie genauer prompten.

1792620136305.png


Zu den Settings von dem Xwing Bild, habe ich vom Original übernommen, das waren diese:
1792620420603.png
 
Zuletzt bearbeitet:
  • Gefällt mir
Reaktionen: samuelclemens
Danke ^^ Und unter der Haube laufen bei SwarmUI und ComfyUI wohl andere Dinge ab ^^ Komme nicht annähernd an das Bild ran ^^ Aber das schaue ich mir morgen mal genau an ^^
 
CountSero schrieb:
@MechanimaL hast du mal die restlichen Setting ? weil ich komme nicht annähernd an die Qualität ^^ Von daher würde ich das gerne mal mit den 1:1 Settings testen ^^
ich glaube das meiste macht die höhere Basis Auflösung aus und die Sampler Scheduler Kombi könnte auch etwas besser sein, als was ich verwendet habe (euler/simple). Das eine leichte cfg Absenkung bei Fotorealismus helfen kann, hab ich schon bei den Test Portraits gemerkt. Also 2.5 sieht meistens im Gesicht echter aus. Habe ein paar schöne mit deinem "Kalt Prompt" gemacht grade, aber überall noch kleinerer Nachbearbeitungsbedarf, sonst würd ichs direkt schicken.. die Anatomie-Probleme sind halt stärker als bei Krea, aber das kann man richten bzw. wird sich noch geben, jetzt ist es schon wieder so spät.. also gute nacht! ^^
 
  • Gefällt mir
Reaktionen: CountSero
CountSero schrieb:
Danke ^^ Und unter der Haube laufen bei SwarmUI und ComfyUI wohl andere Dinge ab ^^ Komme nicht annähernd an das Bild ran ^^ Aber das schaue ich mir morgen mal genau an ^^
Hast Du mal Deinen Workflow für MOSS mit den Std Workflows in Comfyui verglichen? Ist das Ergebnis dort auch nicht zufriedenstellend?
 
Hat sich wer eigentlich schon das brandneue Qwen Chat in ComfyUI angeschaut!?
Anscheinend soll es direkt die Workflows analysieren können und einem dabei assistieren können.
Bei mir hat es null geklappt.
Nehm auch stark an das es auf online Modelle zugreift. Schmeckt mir garnicht das es meine Workflows irgendwo hochlädt zum analysieren.
Muss mir mal ansehen wie man das Teil komplett deaktiviert oder auf reinem Offlinebetrieb umstellt!
 
@MechanimaL Ok, das hat wieder ein Rabbit Hole für mich aufgemacht, weil ich zu naiv gedacht habe. Heute gab es ein großes Update für Fedora 44 mit neuen Mesa-Treibern, und das hatte mich auf die Idee gebracht, das letzte Bild von gestern noch mal neu zu rendern, also 1:1 die Settings wie gestern Nacht.

Und oh Wunder, es kam ein anderes Bild raus, aber das hat mich mal veranlasst zu recherchieren.

Also, wenn man nicht gerade 1:1 das gleiche System und Settings hat, wird es wohl auch nichts mit dem gleichen Bild. Ich dachte ja, solange der Seed, KSampler Settings und die Prompt-Werte übereinstimmen, müsste das Bild sehr identisch sein, aber der Seed allein reicht schon lange nicht mehr aus.

Jeder Grafikkartentyp, das Betriebssystem (wie Linux/Fedora), jeder Treiber (bei Mesa), jede PyTorch-Version, die ROCm-Version für PyTorch, die ComfyUI-Version und sogar kleine Code-Änderungen bei Samplern und Schedulern spielen alle mit rein. Sie beeinflussen das Ergebnis, weil sich hier die Rechengenauigkeit im Nachkommastellenbereich verändert und sich diese minimalen Abweichungen über die Iterationen aufsummieren.

Ich nutze ja nicht die Original-Loader für das Modell und den VAE, ich kann ja auch den compute_weight einstellen, sprich, ich kann zwar ein fp8-Modell laden, es aber forcieren, mit fp16- oder bf16-Genauigkeit zu berechnen, was noch mal das Ergebnis beeinflusst.

Das Rabbit Hole ist also echt tief für mich geworden, theoretisch sind dann alle Angaben zu Modell und Settings eigentlich nur noch Makulatur, und wenn man nicht zufällig ein Klonsystem hat, wird man nie annähernd ein gleiches Bild erstellen.

Und da du SwarmUI verwendest und ich ComfyUI, kommt noch ein weiterer Faktor hinzu, bzw. inwieweit hier SwarmUI noch seine eigenen Optimierungen eingebracht hat.

Am Anfang habe ich noch gedacht, dass derselbe Prompt und dieselben Settings annähernd ein sehr ähnliches Bild erzeugen, aber das habe ich nun verstanden, es ist nicht so ^^.

Also, hier das Bild von gestern Abend, also mit alten Treibern.
MOSS -Gestern.webp


Das von Heute mit neuen Treibern:
MOSS -Heute.webp

Image generated with moss_image_base_bf16 via ComfyUI using the following settings:
Step 1 | Resolution: 1824x1248 | seed: 910439847, steps: 8, cfg: 2.5, sampler: dpmpp_2m_sde_heun_gpu, scheduler: sgm_uniform, denoise: 1.0


Settings und Prompt bei beiden gleich, mit 8Step LoRa^^

Und weil es so schön war nochmal das Bild mit deinen Settings (Neue Treiber):
1to1settings.webp

Image generated with moss_image_sft_int8_convrot via ComfyUI using the following settings:
Step 1 | Resolution: 1824x1248 | seed: 910439847, steps: 25, cfg: 2.5, sampler: er_sde, scheduler: sgm_uniform, denoise: 1.0


Hier noch die beiden Subgraphen, einmal mit den klassischen Loadern links und die von KJNodes rechts

Loader.webp
Loader_2.webp


Und ja, ich habe den Standard-Workflow von ComfyUI mit meinem verglichen. Bei gleichen Settings und Einstellungen kommt 100 % das gleiche Bild raus. Somit passt meine Zusammenstellung und meine Custom Latent Node (dachte hier wäre meine Fehlerquelle, dem war aber nicht so).

Es ist somit definitiv die Unterschiedliche Rechengenauigkeit die für jedes System anders beeinflusst wird durch die oben genannten Unterschiede.


@samuelclemens Mmh ist das ein Template ? oder Nodes ? Beides finde ich jedenfalls nicht unter ComfyUI (bin aber auch unter Linux, evtl haben wir noch nicht das UpDate^^)
 
  • Gefällt mir
Reaktionen: RyzA und AndreasF1975
@CountSero Bei mir war es nach dem Update direkt links in der Menüseitenleiste zu sehen. Ich hab allerdings die Portable Version mit dem neuesten Updates, nicht das stable.
 
CountSero schrieb:
wenn man nicht zufällig ein Klonsystem hat, wird man nie annähernd ein gleiches Bild erstellen.
Interessante Idee. Wäre mal eine kleine Herausforderung sowas zu bauen
Allerdings stecke ich da nicht so tief in der Materie drin.
Aber ich habe mal ein fremdes KI durch verschiedene Editodelle/Workflows in ComfyUI gejagt mit dem Ziel möglichst identische Ergebnisse ohne abänderungen zu erhalten.
Ziel waren die seeds die dabei entstehen mit denen ich dann versuchen wollte identische Bilder ohne Referenubild zu erzeugen.
Bei einem Klon Workflow müsste man eher von der Seite herangehen.
Also eher Reverse Engeneering. Das Bild als Ausgangslage, nicht der Prompt.
Ergänzung ()

CountSero schrieb:
Ok unter der Nightly unter Linux sehe ich da nichts ^^
Vielleicht kann ja jemand das hier screenshotten. Ich kann momentan nicht an den Rechner.
 
Mit Klonsystem meinte ich schon den PC von der Hardware bis zur Software^^ Weil ROCm auf Windows wohl anders kompiliert wurde als für Linux usw.

Aber deine Idee klingt auch interessant ^^

Ich habe mal den Vibe Coder ausgepackt und da ist die Node die zwei Bilder "Visuell" vergleicht ^^:

Test.webp

(Das waren die 2 Bilder von meinem Post zuvor, die mit unterschiedlichen Treiber generiert wurden)

Das Problem ist eher, dass man hier einen Loop-Workflow und noch ein paar Custom Nodes bauen müsste.

Du müsstest eine Node haben, die die % einliest und je nach Vorgabe entscheidet > Wenn die Prozente zu gering sind, dann den Seed erhöhen und den Workflow noch einmal zu starten usw.

Noch eine Node die evtl Bilder oder eine Seed Liste Speichert wenn man 95% Ähnlichkeit erreicht usw.

Wäre bestimmt Interessant aber aufwand und je nach dem wird es wohl lange dauern, das heißt man müsste evtl. eine Loop Max angeben. Auch würde ich jetzt meinen Rechner nicht einfach mal so ballern lassen ^^
 
  • Gefällt mir
Reaktionen: samuelclemens
@CountSero Also war es letztlich irgendwas im Treiber, warum das nicht klappen wollte, denn jetzt hast Du ja die gewünschte Optik erreicht, sauber! :)

Ja das exakt gleiche Bild habe ich auch nicht hinbekommen (also wie das Ausgangsbild, dachte eigtl. das könnte gehen, bzw. dass die Abweichungen geringer wären, aber es ist (im Rahmen des Prompts) wie, als hätte man einen anderen Seed verwendet. Früher (vielleicht erinnere ich mich falsch) - das war noch unter A1111 SD - konnte ich glaube ich Bilder genauer nachbilden. Da gabs evtl. auch einfach weniger Variablen im Prozess.
 
  • Gefällt mir
Reaktionen: CountSero
CountSero schrieb:
Du müsstest eine Node haben, die die % einliest und je nach Vorgabe entscheidet > Wenn die Prozente zu gering sind, dann den Seed erhöhen und den Workflow noch einmal zu starten usw.
Eigentlich ist es sogar noch komplexer. Man muss nicht nur den Seed varrieren sondern sämtliche Parameter die das Bild beeinflussen könnten und die einstellbar sind. Ich würde hier ganz auf die grafische oberfläche verzichten und gleich mit den json Dateien per API arbeiten.
Evtl vielleicht sogar den Bildervergleich von außen mit einer alternativen Methode zur KI durchführen wenn die ComfyUI node zu lange dauert.🤔
Man versucht simpel so oft unterschiedliche Einstellungen bis das Ergebniss übereinstimmt.
Aber ob es nen vernünftigen Anwendungszwecke hätte weiss ich nicht!?
Vielleicht wenn man zu nem Bild die Metadaten nicht hat und was ähnliches erstellen will!?
 
Zuletzt bearbeitet:
  • Gefällt mir
Reaktionen: CountSero
MechanimaL schrieb:
@CountSero Also war es letztlich irgendwas im Treiber, warum das nicht klappen wollte, denn jetzt hast Du ja die gewünschte Optik erreicht, sauber! :)
Nein, das nicht, die Treiber waren bis jetzt alle sauber. Mein Verständnis hinter dem Ganzen war das Problem, weil ich dachte, mit den bekannten Settings kann man das Bild easy zu 100 % nachbilden, aber dem ist ja nicht so.

Alleine das Verwenden einer Nvidia-Karte oder Radeon-Karte auf dem gleichen System würde sofort ein anderes Bild ergeben. Es liegt halt an den Unterschieden, die sich von der Hardware über die Treiber bis zur Software ziehen. Also du SwarmUI und ich ComfyUI.

Es ist sogar so, dass auf dem gleichen System unter Windows ein anderes Bild entsteht als unter Linux, weil das Kompilieren die Genauigkeit beim Rechnen beeinflusst. Und jede Abweichung sind halt Anomalien.

Wie du ja auf den Bildern siehst, zwischen altem und neuem Treiber ist es zu 95 % das gleiche Bild, aber dennoch weichen Kleinigkeiten ab, wie die Personen im Hintergrund, die Kleidung von Luke usw.

Deswegen ist eigentlich die Angabe von Seed, Scheduler, Sampler, CFG, Modell alles nicht wirklich ausreichend. Denn wie man sieht, ergibt es mit den gleichen Settings auf deinem System ein anderes Bild als auf meinem. Es ist eher ein Richtwert, und wenn man Glück hat, bekommt man eine 90-prozentige Genauigkeit ^^

Mein Verständnis war dann bis heute das Problem, nun bin ich aber erleuchtet ;) Und nun jage ich dem weißen Hasen nicht mehr nach^^ Ich weiß nun, dass es nur ein Richtwert für ein ähnliches Bild ist, nicht für einen Volltreffer. Der Rest ist dann mein Feingefühl wie ich meine Settings einstelle um das Ergebnis zu verbessern.

Somit, ich war dumm und nun habe ich gutes Halbwissen. ^^

@samuelclemens
Ich kann mir schon vorstellen, dass die Werbeindustrie schon so arbeitet. Die haben wohl auch die Ressourcen, sowas durchzuziehen, um halt Varianten von Werbekampagnen zu erstellen, die immer noch dem ursprünglichen Original zu 90 % bis 95 % entsprechen, aber dennoch was Neues bieten. Aber ich vermute, dass sie hier LoRAs oder Custom-Modelle mit ihren Kampagnen trainieren, um ihren Style zu erreichen.Ich habe schon in einigen Magazinen gesehen, dass dort stand: „Dieses Bild ist KI-generiert“.

Und das mit dem Seed war ja nur ein Beispiel, man kann das Ganze ja viel weiter spinnen. Ich wollte nur deine Idee aufgreifen ^^ Fand es interessant und hat mich die Bildvergleich-Node Vibe coden lassen, evtl. wird das noch mal praktisch ^^

Wahrscheinlich gibt es bestimmt auch Private User die durch solche Loops die Parameter Suchen um evtl einem Bild so nahe zu kommen wie sie es wünschen.

Aber für privat sehe ich dennoch da nur bedingt einen Nutzen, da reicht mir meine reine Image-to-Text-Variante, um einen Basis-Prompt zu einem Bild zu erstellen. Wobei man hier der KI ja bereits Anweisungen geben kann à la „Describe the image in epic details, change the daytime to night, change the person to ...“ usw. Ist nicht perfekt, aber bringt mit dem passenden System-Prompt bereits eine gute Basis für einen Bild-Prompt. Dann kann man von hier aus auch seine Generierungsreise beginnen. Wie ich heute gelernt habe, zu 100% wird man es wohl eh nicht treffen^^
 
  • Gefällt mir
Reaktionen: AndreasF1975 und samuelclemens
Hier mal ein chilliges Bild:

Mit der kostenlosen Version von ChatGPT erstellt.

Erstelle ein episches und cinematisches Bild von einen Jungen der auf einer Schaukel bei Abendlicht schaukelt. Die Seile der Schaukel sind an einen längeren Ast von einen Baum befestigt. Die Schaukel reicht fast bis zum Boden. Am Himmel sind Sterne zu sehen. Außerdem ein paar Sternschnuppen. Man sieht im Bild auch noch das kleine Haus wo der Junge wohnt. Darin sind noch Lichter an. Am Himmel steht in wolkenähnlicher Schrift "Live your Dream"
Ich brauchte ein paar Versuche und musste das mit dem Seil genauer definieren. Weil es sonst zu kurz war.

Träume unter dem Sternenhimmel.png
 
  • Gefällt mir
Reaktionen: samuelclemens, CountSero und AndreasF1975
CountSero schrieb:
Nein, das nicht, die Treiber waren bis jetzt alle sauber. Mein Verständnis hinter dem Ganzen war das Problem, weil ich dachte, mit den bekannten Settings kann man das Bild easy zu 100 % nachbilden, aber dem ist ja nicht so.
Das ist nochmal gut als Bestätigung, es ist halt wie ein anderer Seed, dennoch kann man ja versuchen eine Komposition (wenn es relevant ist, wo was angeordnet ist usw.) auch noch genauer nachzubilden, wenn man das möchte. (Für sowas gibt es neben dieser bbox Funktion auch noch die Option, sich das Bild einfach genauer zu beschreiben vom Aufbau her / bzw beschreiben zu lassen - oder etwas in der Richtung von Controlnet, wofür es bei MOSS auch schon eine Möglichkeit gibt, hatte ich verlinkt).

Dennoch: Das letzte Bild in Deiner Reihe von 3 entspricht qualitativ als einziges der Optik von dem, was wir beide anhand der Parameter vom Originalbild erstellt haben, wohingegen die beiden davor, ganz und garnicht so gut aussehen. Und soweit ich Dich verstanden habe, ist die Änderung dazwischen der Treiberwechsel gewesen - oder nicht?
 
  • Gefällt mir
Reaktionen: CountSero
CountSero schrieb:
Ok unter der Nightly unter Linux sehe ich da nichts ^^
OK, falscher Alarm, war doch eine Extension dafür verantwortlich! :mussweg:
 
  • Gefällt mir
Reaktionen: CountSero
@MechanimaL
Ja, die beiden mit dem Tag "Gestern" und "Heute" (das ist mit neuen Treibern) waren Experimente, auch mit dem Base-Modell und dem 8-Step-LoRA. Dass die anders sind, war abzusehen. Entscheidend für mich war hier halt das der Treiber alleine schon Auswirkung auf das Bild hatte.

Und ja, natürlich ist so ein Prompt nur ein Anfang, auf dem man aufbauen kann, bis man etwas hat, das einem gefällt. Von BBox und ControlNet bin ich kein Fan, besonders bei ControlNet bildet man ja nur nach, anstatt etwas Neues zu kreieren, aber das ist auch nur meine Meinung.

Ich habe mit Depth Control und so experimentiert, aber damit war ich nur bedingt zufrieden.

Wie gesagt ich bin da mit den absoluten falschen Verständnis ran gegangen ^^
 
Zuletzt bearbeitet:
Zurück
Oben