Du verwendest einen veralteten Browser. Es ist möglich, dass diese oder andere Websites nicht korrekt angezeigt werden. Du solltest ein Upgrade durchführen oder einen alternativen Browser verwenden.
[Sammelthread] AI - Bildgenerierung (Stable Diffusion, Midjourney & Co)
Wenn das Bild irgendeinen Mehrwert zu bieten hat wo man meint es könnte jemanden interessieren ist doch ok.
Auch völlig zufällig entstandene Bilder können interessant sein oder einen Mehrwert bieten wenn man die Daten zum reproduzieren mit gibt.
In den ComfyUi Bildern sind standardmæßig alle Metadaten enthalten inklusive dem exakten seed um ein möglichst ähnliches Bild reproduzieren zu können.
Ich selbst entferne allerdings sämtliche Metadaten aus den Bildern die ich hochlade.
Ich finde es schon wichtig hier irgendwas mitzugeben am Entstehungsprozess.
KI Bildergalerien mit voting hat man mittlerweile endlos auf allen Plattformen die KI anbieten.
Aber auch wenn es nur eine interessante Motividee ist kann man dies als Mehrwert zählen.
Und ja, man bemerkt hier eine gewisse "Tendenz" was die Motivwahl angeht.🙄
Also "Spam" müsste ein so ein Thread ja beileibe nicht sein, mit entsprechenden Posting Regeln/Guide-Lines, ich kann aber verstehen, wenn das erstmal so eingeschätzt wird. Klar mag da auch eine Haltung mitschwingen, dass ja AI Bilder nichts besonderes/wertvolles seien, aber das ist eine andere
. Das liegt meiner Meinung nach ausschließlich im Auge des Betrachters - wortwörtlich
Auch für meine (im Vergleich wahrscheinlich weniger ästhetisch wertvollen) Bilder gehen häufig Stunden oder mehrere Anläufe an verschiedenen Tagen drauf, bis ich zufrieden bin, weil man noch xy anpasst und probiert und eine Ausgangsidee selten direkt "fertig" ist. Es fallen einem weitere mögliche Details ein, Fehler oder Schwachstellen müssen behoben oder umgangen werden und ggf. muss man von "Hand" Dinge nachbessern usw. usf.. Und egal wie lange es dauert: Wenn man am Ende ein zufriedenstellendes Ergebnis erreicht, ist es ein gutes Gefühl, etwas erschaffen zu haben, das es sonst nicht gäbe. Wenn jemand trotzdem sagt, das ist KI, das ist weniger wert oder das mag ich nicht, ist das für mich vollkommen in Ordnung, das akzeptiere ich, es nimmt mir aber nicht den Spaß oder das Interesse daran.
Ich sehe selbst aktuell aber auch keinen Grund, warum die Bilder nicht in diesem Thread bleiben könnten, das lockert es ja neben dem ganzen Text auch auf, was von Beginn an auch so beabsichtigt war. Wenn es zuviel wird, könnten wir zunächst über Regeln/Guide-Lines sprechen und dann immer noch nach einer Lösung für eine Extra Art Gallerie suchen.
Zum Thema Steampunk wollte ich mich damals direkt einklinken mit einer Idee, konnte aber nicht posten, weil die Dateien zu groß waren (hatte es mit dem Upscalen "übertrieben") und hatte da keine Zeit mich mit dem "Problem" noch weiter zu befassen, also etwas verspätet noch ein kleiner Beitrag von mir der auch die Wirkung vom SeedVR2 nochmal aufzeigen soll, mit einer kleineren Variante meiner Bildidee. (Während ich für heute noch auf dem Plan habe, Verkleinerungsmöglichkeiten zu probieren, anhand der größeren Dateien; Info folgt.).
Ein Beispiel für ein mögliches Vorgehen mit Latent Upscaling ist:
1. Original Bild Komposition: Idee entwickeln und Prompt schreiben (ggf. "enhancen" lassen) Auflösung/Seitenverhältnis, ggf. Loras probieren, Basics Checken, Prompt anpassen usw. bis bei einem alles weitgehend passt
2: Upscale, entweder mit Tools/Upscalern oder Latent. Hier gibt es verschiedene Ansätze. Hatten wir auch zum Teil hier im Thread schon, häufig werden dann andere Modelle in Kombination mit Upscale Modellen verwendet oder der etwas einfachere Ansatz, wie bei den Steampunk Bildern (weiter oben) Latent-Upscaling mit dem selben Modell. Da das aber am Ende häufig etwas unscharf wirkt (sieht man insb. beim Reinzoomen) finde ich, dass sich (oft - nicht immer) noch der
3. SeedVR2 Upscale lohnt (man kann ihn auch rein als "Refiner" ohne Upscale verwenden, aber mit z.B. 1.5x Upscale aufwärts hat er mehr Wirkung und bringt noch extra Details). (Ganz unten ist der Vergleich verlinkt).
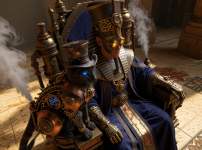
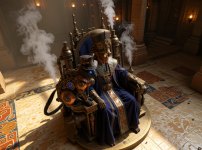
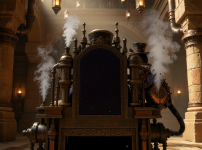
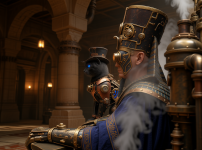
Hier mal ein Steampunk Pharao mit Katze: Modell: Krea2, (Steampunk Lora mit 0.3), Latent Upscale mit x1.35 /0.53 Denoise und anschließend: SeedVR2 x1.5 (7b bf16).Ich hatte auch noch komplett mechanische Katzen, was ja bei meinem Namen gut passt, und glaube ich jetzt die nächste Challenge für ein Profilbild von mir wird Zuerst hatte ich nur die Idee vom Pharao, auf einem Thron, dann kam mir die Katze in den Sinn, dann dass der Thron natürlich auch eine Art Maschine ist usw.. aber die Steampunk Lora machte bei Werten über 0.2/0.3 immer Uhren aus den z.B. leuchtenden Monokeln und ähnlichen Bestandteilen. Sie macht das Bild auch etwas dunkler bzw. düsterer, aber bringt ganz gut Metall und Oberflächen davon, sowie Maschinen-Stil rein.
EDIT: Speichern als webP mit "high quality" preset (in nomacs) von ~12 auf ~2mb. (oxipng hatte ca 1-2mb am png verkleinert). --> falls PNG zu groß, kann das z.B. eine Lösung zum Posten hier sein. (statt downscaling)
@MechanimaL Könnte man das mechanische Exoskelett an den Gelenken der Katze nochmal etwas abändern?
An der Pfote unten sieht man ja dass die Beine durchgehend sind aber das Scharnier am Gelenkt sieht so aus als würde es komplett durchs Bein gehen. Rein logisch betrachtet!
Vielleicht würde es besser aussehen wenn die Beine Komplett mechanisch wären inklusive Pfoten? 🤔
Wegen dem Rauch sollte man auch was machen. das sieht oft unecht aufgemalt aus.
Schonmal Umformulierungen probiert wie "nebel" oder so?
Habe mich heute mal ein bisschen durch das neue MOSS-Image getestet. Standard Text to Image Workflow in Comfy. Bin schon einigermaßen beeindruckt, es sind schöne Bilder dabei, leider auch ein paar Nieten (Klaviatur? ich mach einfach mal weiß-schwarz immer abwechselnd. Kalligraphie-Federhalter? Holzblock mit "Messer" drin wird reichen. Dabei einmal tolle "Glanzeffekte" auf den Klaviertasten, also, sahen dahingehend richtig gut aus, die Holzmaserung bei den Kalligraphie Tests war, ohne Sarkasmus, wirklich beeindruckend.
positive:
An exquisite, photorealistic still life on a refined dark mahogany writing desk. A slender traditional wooden dip pen with a tiny, delicate pointed steel calligraphy nib rests diagonally beside a crystal-clear glass inkwell filled with deep cobalt-blue ink. The pen holder is slim and elegant, with realistic proportions. The small polished steel nib has two fine tines, a precise central slit, and a delicate pointed tip, unmistakably designed for traditional pointed-pen calligraphy.
Across the upper third of the composition, the exact heading "The Art of Fine Writing" is written in extraordinarily refined English Copperplate calligraphy, executed with the precision and grace of a master penman. Exquisite hairline upstrokes, impossibly fine yet controlled entry strokes, elegant oval letterforms, beautifully shaded downstrokes with graceful transitions from hairline to full pressure, delicate flourishes, refined connecting strokes, exquisite letter spacing, and perfectly balanced proportions. The lettering evokes the finest nineteenth-century English roundhand penmanship, with the elegance of an original hand-lettered calligraphic masterpiece. The hairlines are exceptionally thin, graceful, and crisp, while the shaded strokes are rich, smooth, and distinctly contrasted. Every letter is individually formed with impeccable Copperplate structure, fluid rhythm, and sophisticated ornamental restraint. The capital letters feature beautifully controlled flourishes without sacrificing legibility. The text is centered, impeccably spelled, and surrounded by generous negative space.
Soft natural window light reveals the delicate grain of the mahogany, the subtle silver reflections on the steel nib, and the luminous transparency of the blue ink. Restrained warm highlights, rich natural shadows, exquisite material realism, fine-art still-life photography, luxurious traditional writing atmosphere, museum-quality craftsmanship, understated elegance. The heading remains the dominant decorative element, with the pen and inkwell arranged below it as a harmonious visual complement.
So, ich habe mich nun ein paar Tage mit MOSS-Image beschäftigt und denke, es könnte bei mir eventuell sogar KREA2 ablösen.
Für mich ist es ein sehr starkes Modell, das man lokal betreiben kann, und es ist imho ressourcenschonender als KREA2 bei den Auflösungen, die ich fahre.
Unter Fedora musste ich nur auf die Nightly-Version von ComfyUI wechseln, damit der Support von MOSS-Image für den Clip-Loader einzug erhält aber sonst war alles easy. Hier nochmal Danke an den Tipp @MechanimaL
Anders als bei KREA2 muss ich bei MOSS-Image einen Positiv- und Negativ-Prompt nutzen. Bei Condition Zero Out bekomme ich Bildfehler (kann aber auch an einer meiner Custom Nodes liegen, da bin ich aber dran). Ich habe bis jetzt aber noch nicht den Negativ-Prompt nutzen müssen, läuft ziemlich rund auch ohne.
Wenn man rein das Basismodell nutzt (ohne die 8-Step-LoRa, die bereits im Umlauf ist), braucht man 50 Steps bei einem CFG zwischen 3 und 5. Generell funktioniert das wunderbar und ich habe fast keine Anomalien erzeugt, die der Rede wert waren. Auch die Anatomie war zu 95 % sehr gut. Aber ohne 8-Step-LoRa nimmt es natürlich wesentlich mehr Zeit in Anspruch. Es ist dann zwar auch einen Tick akkurater, aber der Zeitgewinn mit der 8-Step-LoRa macht das locker wett. Unten gibt es mehr zu den Renderzeiten.
Das Textverständnis ist ziemlich gut, aber man muss auch hier auf die Wortwahl achten. Da es sich um ein "offenes" Modell handelt, muss man bei körperbetonter Kleidung und/oder leichten Stoffen aufpassen. Besonders dann, wenn man so wie ich einen zweiten KSampler als Refiner/Upscaler nutzt, sonst ist man schnell bei anatomischen Details, die sich durch die Kleidung abbilden (das ist dann auch geschlechtsunabhängig).
Positionierung allein durch Beschreibung funktioniert recht gut und ist nicht zu beanstanden, aber ich weiß, dass man hier auch mit einem JSON-Format systemkoordinatenbasiert positionieren kann. Da habe ich mich aber noch nicht eingearbeitet, sondern es nur überflogen. Ich habe generell noch nicht die Basisdaten von MOSS-Image zu Gemüte geführt, das werde ich nach und nach mal nachholen.
Die Standardkombination aus dem Beispiel-Workflow mit 1024x1024 mit Euler und sgm_uniform läuft wunderbar und zügig, ich bevorzuge aber exp_heun_2_x0_sde und sgm_uniform. Meines Erachtens kommen hier die schöneren Details bei rum, aber sowas ist halt auch immer Geschmackssache bzw. eine Frage davon, wie lange man auf das Bild warten will. Ich würde sagen hier einfach mal die verschiedenen Kombinationen durch testen und selber schauen.
Die Speicherbelegung ist wesentlich moderater als bei KREA2. Bei gleicher Latent-Größe bin ich im Schnitt 1–2 GB leichter im RAM unterwegs und brauche auch 1–2 GB weniger VRAM. Das heißt, dass ich hier wesentlich entspannter Bilder generieren kann als mit KREA2, was für mich ein dickes Plus ist.
Das heißt, wenn ich nur einen KSampler nutze, kann ich nach dem Kaltstart locker einige Bilder mehr rendern als mit KREA2. Irgendwann habe ich hier aber auch einen Memory Leak, der den RAM frisst. Woran es liegt, kann ich nicht sagen, aber ich vermute, dass sich hier irgendwelche Reste ansammeln, die nicht sauber entladen oder aufgeräumt werden. Ist wohl ein AMD/ROCm-Problem.
Die oben genannte LoRa findet man schnell auf HuggingFace, aber die ist ein Game-Changer: Anstelle der 50 Steps reichen 8 für ein Bild aus, und für den Refiner/Hi-Res Fix reichen auch locker 4 Steps. Das spart enorm Zeit!
Nachfolgend ein Screenshot von der Konsole:
Hier sieht man, dass ich beim Kaltstart mit 1024x1024, Euler und sgm_uniform ca. 70 Sekunden für das Bild brauche. Das zweite Bild war dann mal eben in ca. 21 Sekunden da, was enorm schnell ist.
Der nächste Screen zeigt einen Warmstart mit meinem üblichen Setup:
Das heißt, mit dem moss_image_sft_bf16 und 2 KSamplern brauche ich ca. 65 Sekunden mit diesen Settings:
Was für mich ca. 60 % schneller ist als bei KREA2.
Als Workflow nutze ich einen leicht abgewandelten KREA2-Workflow, den ich bereits vorher vorgestellt habe. Die einzige Änderung war in der Latent-Node, dass ich hier auch auf FLUX umstellen musste.
Ich kann also jedem nur empfehlen, es mal zu probieren – meiner Meinung nach ein sehr gelungenes Modell.Ich werde noch weiter testen und schauen, wie es sich entwickelt (sprich LoRas usw.).
Anschließend gibt es noch ein paar Bilder um mal so grob die Qualität von MOSS-Image zu zeigen^^
Das erste ist fast der gleiche Prompt von einem Bild, das ich unter KREA2 in dem Post weiter vorher bereits erstellt hatte.
CyberPunk Hacker
Image generated with moss_image_sft_bf16 via ComfyUI using the following settings:
Step 1 | Resolution: 1344x768 | seed: 1976, steps: 8, cfg: 3.0, sampler: exp_heun_2_x0_sde, scheduler: sgm_uniform, denoise: 1.0
Step 2 | Resolution: 2016x1152 (Upscaled x1.5) | seed: 1976, steps: 4, cfg: 3.0, sampler: exp_heun_2_x0_sde, scheduler: sgm_uniform, denoise: 0.6
Cosy HumingBird
Image generated with moss_image_sft_bf16 via ComfyUI using the following settings:\nStep 1 | Resolution: 1344x768 | seed: 1976, steps: 8, cfg: 3.0, sampler: exp_heun_2_x0_sde, scheduler: sgm_uniform, denoise: 1.0\nStep 2 | Resolution: 2016x1152 (Upscaled x1.5) | seed: 1976, steps: 4, cfg: 3.0, sampler: exp_heun_2_x0_sde, scheduler: sgm_uniform, denoise: 0.6
HappyHalloween (Ein bisschen Ironisch ):
Image generated with moss_image_sft_bf16 via ComfyUI using the following settings:\nStep 1 | Resolution: 1344x768 | seed: 1976, steps: 8, cfg: 3.0, sampler: exp_heun_2_x0_sde, scheduler: sgm_uniform, denoise: 1.0\nStep 2 | Resolution: 2016x1152 (Upscaled x1.5) | seed: 1976, steps: 4, cfg: 3.0, sampler: exp_heun_2_x0_sde, scheduler: sgm_uniform, denoise: 0.6
HappyHalloween :
Image generated with moss_image_sft_bf16 via ComfyUI using the following settings:\nStep 1 | Resolution: 1344x768 | seed: 1976, steps: 8, cfg: 3.0, sampler: exp_heun_2_x0_sde, scheduler: sgm_uniform, denoise: 1.0\nStep 2 | Resolution: 2016x1152 (Upscaled x1.5) | seed: 1976, steps: 4, cfg: 3.0, sampler: exp_heun_2_x0_sde, scheduler: sgm_uniform, denoise: 0.6
Cinematic wide-angle 21mm photorealistic 8K shot of a sprawling haunted mansion on Halloween night, fog curling through the overgrown ivy and decaying Victorian architecture, broken transom windows and a crumbling stone portico framing the scene, torches and carved jack-o-lantern pumpkins with flickering candlelight casting warm amber and green phosphorescent glow across crumbling stone steps and rotting wooden doors, thick cobwebs and spider webs draped between wrought-iron railings and crumbling gargoyles, a tattered black banner hanging limp from the portico, scattered dried leaves and twigs underfoot. In the foreground a 45-year-old Irish woman named Maeve, soft hourglass silhouette, vivid copper-red hair, luminous pale blue eyes visible beneath the mask, a small golden septum hoop piercing her nose, a delicate threader earring with an emerald-green teardrop pendant swaying on her left ear, standing tall and dominant in a tattered black-and-bone grim reaper costume with the pointed hood pulled up over her head, a white hockey mask covering her face with two glowing green eye-gaps and a stitched-up mouth, a long curved scythe raised in her right hand the broad blade radiating an intense neon green phosphorescent glow casting long cold green light across her costume and the stone facade, the handle wrapped in frayed black leather. Beside her at her feet a small scruffy dog in a tattered zombie costume with ripped fabric and fake blood, the dog's muzzle gripping the wooden handle of a miniature jack-o-lantern pumpkin bucket half-filled with wrapped candy bars and lollipops, the bucket's candle flame flickering inside. Scattered across the steps and garden beds are additional carved pumpkins with flickering candles, a pile of candy-stuffed gourd, cobweb-draped topiary, and a few scattered dead leaves. The overall palette is deep umber, umber green, candlelight amber, and cold phosphorescent green neon from the scythe blade, atmospheric volumetric fog and particulate light, cinematic depth of field with the mansion receding into misty darkness behind, 21mm ultra-wide lens, 8K photorealistic render, moody Halloween atmosphere, volumetric god-rays from window candles piercing the fog, shallow atmospheric perspective dissolving the far wings of the mansion into black
@MechanimaL
Ja, SeedVR ist sehr gut und ich habe auch einen Workflow, in dem ich es getestet habe, aber ich bin zu bequem, ihn immer zu nutzen, weil es extra Zeit kostet.
Leider bin ich auch mit zu wenig RAM gesegnet und kann ihn nicht direkt in den Workflow bauen^^
Aber ja, die Qualität kann sich sehen lassen, die Dateigröße ist für mich kein Problem, da ich eigentlich alle Bilder in JXL abspeichere^^
samuelclemens schrieb:
Aber auch wenn es nur eine interessante Motividee ist kann man dies als Mehrwert zählen.
Und ja, man bemerkt hier eine gewisse "Tendenz" was die Motivwahl angeht.🙄
So sehe ich das auch, viele Motive dienen für mich eher als Ideen Lieferant, wo ich selber evtl noch nicht drauf gekommen bin ^^
Und welche "Tendenz" Meinst du ?
@AndreasF1975 ich finde es OK wenn du Bilder Postest, für mich sind die eine Quelle für neue Ideen wie alle anderen Bilder hier.
Vigilant schrieb:
Mir fehlt hier ehrlich gesagt auch der Kontext. Warum Bilder Posten, ohne einen Kontext? Ich kann hier Comfy auch anweisen, mir per Batch in einer Stunde knapp 100 Bilder zu generieren und dabei ordentlich Strom zu verballern. Aber warum sollte ich die hier zeigen wollen? Was haben andere User davon? Wenn dir das wichtig ist, könntest auch einen Account bei Civitai oder Reddit anlegen und dort die Pics teilen.
Interessant in diesem Thread finde ich den Austausch über die Technik, Tools und Herangehensweise. Das generiert auch einen Mehrwert für andere, das xte KI-Mädel in merkwürdigem Style nicht.
Lass das nicht zum Fetisch werden 😉. Am Ende wird das zur Slot-Machine mit Sucht-Charakter.
Kritik ist willkommen, aber sie sollte Hand und Fuß haben und danach wünsche ich mir aber auch Beteiligung, sonst wirkt es wie "Nörgeln", evtl. mal drüber nachdenken
@samuelclemens ja und nein ^^ bei der unteren der beiden Katzen fand ich die rechte Hinter-Pfote auch etwas zu groß, aber noch im Rahmen des - evtl durch etwas Quetschung (Miau?!) - optisch Möglichen. Dass sie zum Teil tierisch und zum Teil mechanisch ist - und das auch an unzusammenhängenden Stellen, warum nicht? Ist halt ein Dir und mir noch unbekanntes biomechanisches Wesen, ne ? ^^ Bzgl. Rauch: Wer weiß, was für ein Kraut da im Thron verbrannt wird ^^ Wobei es als Dampf (Steam) geprompted ist und gerne auch etwas mehr wie Dampf aussehen dürfte Hat mich aber jetzt beides nicht entscheidend gestört. Aber nehme Deine Idee auf, wenn ich eines davon mit einer vollmechanischen Katze nochmal überarbeite, das grade mitzutesten.
MOSS wird nächste Woche auch bei mir näher getestet, danke für Euren Input dazu!
Möchte ich nicht so verstanden wissen, aber auch klarmachen, dass mich kontextloser Bilderspam nicht interessiert, die Technik und Verfahren aber sehr wohl. Und Beteiligung erfolgt auch je nach Kontext und Zeit. Letztere ist begrenzt.
Ok, ich bin ein bisschen irre. ^^ Ich habe versucht, meinem Refiner Regional Prompting beizubringen. ^^
Aus der Vorgabe:
Create an epic, detailed scene; a cinematic, photorealistic 8K wide-angle shot in steampunk style.
Canvas size: 1344x768
The background of the scene is a Victorian Berlin.
James, a 50-year-old German man, severely obese, with deep brown eyes and short dark-brown hair styled with a neat center part. He has a well-trimmed salt-and-pepper 3-day beard contouring his soft jawline. He wears a top hat and a steampunk Victorian fine suit. The top hat has copper decorations such as gears and straps. His left leg is a mechanical steampunk leg with a small steam engine, gears, and metal joints, all made of copper, brass, and steel. He leans on a steel walking stick with copper inserts; the round handle is a copper skull with teal glowing eyes. In the other hand, he holds a pocket watch. He is standing full-body in the center of the scene.
Far behind in the background on the left, a very small steampunk horse-drawn carriage is visible, pulled by two mechanical horses made of brass, copper, and small steam engines.
In the right foreground corner is a dog, a German Shepherd, which is a mix of a real dog and steampunk parts. The body and limbs are mechanical, while the head, paws, and tail are still real.
{
"summary": {
"caption": "Epic cinematic photorealistic wide-angle 8K shot of a steampunk Victorian Berlin streetscape at golden hour, deep amber and sepia color grading, atmospheric steam and fog rolling between cobblestone streets and gas-lamp glows, a full-body centered figure of James (a 50-year-old severely obese German man with deep brown eyes, short dark-brown hair with a neat center part, a well-trimmed salt-and-pepper 3-day beard contouring his soft jawline, a tall top hat decorated with (copper gears:1.2) and brass straps, a tailored steampunk Victorian fine suit with a fitted waistcoat, a cravat, and a long overcoat with heavy fabric folds and draping, his (severely obese torso:1.25) swelling the suit fabric with natural gravity-driven wrinkles, his (left mechanical steampunk leg:1.3) fully exposed from knee down with (copper and brass steam engine:1.3) and (steel joints:1.2) and small piston cylinders and riveted seams, and his right hand holding a brass pocket watch while his left hand grips a (steel walking stick:1.2) with (copper skull handle:1.2) featuring (teal glowing eyes:1.3) as the handle, all set against a deep-focus Victorian Berlin background with (steampunk horse-drawn carriage:1.2) pulled by (two mechanical brass and copper horses:1.3) visible small in the far-left background, and a (German Shepherd dog:1.3) with (mechanical brass and copper body and limbs:1.3) but real fur head, paws, and tail in the foreground right corner, all rendered in (photorealistic 8K cinematic wide-angle:1.2) with (85mm lens:1.1) and deep atmospheric perspective."
},
"items": [
{
"label": "James",
"caption": "A (50-year-old severely obese German man:1.2) with deep brown eyes, short dark-brown hair with a neat center part, a (well-trimmed salt-and-pepper 3-day beard:1.2) contouring his soft jawline, wearing a (tall top hat:1.2) with (copper gear decorations:1.2) and brass straps, a (steampunk Victorian fine suit:1.2) with a fitted waistcoat, cravat, and long overcoat with heavy fabric folds, his (severely obese torso:1.25) swelling the suit fabric with natural gravity-driven wrinkles, his (left mechanical steampunk leg:1.3) fully exposed from knee down with (copper and brass steam engine:1.3) and (steel joints:1.2) and small piston cylinders and riveted seams, leaning on a (steel walking stick:1.2) with (copper skull handle:1.2) featuring (teal glowing eyes:1.3), his right hand holding a brass pocket watch, standing full body in the center of the frame, facing the camera with a slight head tilt, weight distributed on the cane side, the mechanical leg slightly bent at the knee joint with visible gear rotation and steam vents, copper and brass surfaces with realistic patina and oxidation, the suit fabric draping naturally over his heavy frame with soft creases at the elbows and shoulders, deep shadows under the hat brim and along the neck, gas-lamp rim light catching the top hat rim and the suit shoulder.",
"bbox": [-340, -220, 340, 220]
},
{
"label": "Steampunk carriage and mechanical horses",
"caption": "A (small steampunk horse-drawn carriage:1.3) in the far-left background, pulled by (two mechanical horses:1.3) made of (brass and copper:1.3) with visible gear trains, steam vents, and articulated joint pivots, the carriage body showing riveted steel panels and small glass portholes, the mechanical horse legs with rotating brass joints and copper piston actuators, all receding into the deep background with atmospheric haze and steam, positioned at the far left of the frame with strong perspective diminution.",
"bbox": [-360, -650, -260, -420]
},
{
"label": "German Shepherd dog",
"caption": "A (German Shepherd dog:1.3) in the foreground right corner, its body and limbs constructed from (mechanical brass and copper steampunk parts:1.3) with visible gear assemblies, riveted steel joints, and articulated limb segments, while its head, paws, and tail remain real with natural black-and-tan fur, erect pointed ears, a wet black nose, and a slightly open mouth with a visible tongue, the mechanical body parts showing oxidized copper and polished brass with steam leaks at the joints, the dog standing alert with its head turned toward the viewer, positioned low in the frame with its front paws firmly planted on the cobblestone ground.",
"bbox": [80, 440, 370, 660]
},
{
"label": "Victorian Berlin background",
"caption": "A (deep Victorian Berlin streetscape:1.2) in the background, with (steampunk architecture:1.2) featuring ornate ironwork, gas-lamp posts, cobblestone streets, and soot-stained stone facades, atmospheric steam and fog rolling between the buildings, golden-hour light casting long warm shadows, the scene rendered with deep atmospheric perspective and layered depth, cobblestone textures with realistic wear, distant building silhouettes fading into haze, and the overall color palette dominated by amber, sepia, copper, and muted brass tones with cool teal accents from the mechanical elements.",
"bbox": [-380, -670, 380, 670]
}
],
"bbox_format": "yxyx",
"bbox_coord_space": "abs_centralized"
}
Das ist das Ergebnis:
Image generated with moss_image_sft_bf16 via ComfyUI using the following settings:
Step 1 | Resolution: 1344x768 | seed: 1976, steps: 8, cfg: 3.0, sampler: exp_heun_2_x0_sde, scheduler: sgm_uniform, denoise: 1.0
Step 2 | Resolution: 2016x1152 (Upscaled x1.5) | seed: 1976, steps: 4, cfg: 3.0, sampler: exp_heun_2_x0_sde, scheduler: sgm_uniform, denoise: 0.6
Für einen ersten test doch garnicht so schlecht ^^
Du hast "generate text" mit einem system prompt zur bbox Gestaltung ausgestattet oder wie?
Es gibt recht pratkische Nodes, die für sowas gemacht sind btw., also zb selbst die boxen auf einem Bild ziehen, bzw. ein Bild einlesen und dann die von comfyui erstellten boxen anpassen/verschieben. War spätestens seit Ideogram mit bbox ja auch schon in Gebrauch. Flux3 beherrscht das und Moss. Regional Prompting ging an sich ja schon mit SDXL, manchmal hilfreich um z.B. verschiedene Personen-Prompts /verschiedene Loras usw. nur auf Teile eines Bildes anzuwenden.
Der Vorteil von diesem "generate text" ist wohl, dass man das sowieso schon vorhandene LLM im Text-Encoder bzw. CLIP Ordner benutzt. Werde da selbst auch mal bisschen probieren. Es geht natürlich auch per Hand aus LM Studio o.ä. Prompts rauszukopieren oder mit einer Node, die OpenAI kompatible API unterstützt auch, dass LM Studio (in meinem Fall) angesteuert wird, dort das Prompt erzeugt wird und wieder zurückgesendet wird an ComfyUI. Das hatte ich für Minimax verwendet in der Form, da war bei der All in ONe Node eine solche LLM Schnittstelle. Wenn der Prompt aber gut genug ist, mit dem Text-Encoder-Modell, das eh schon in ComfyUI für die Bilderstellunge geladen und verwendet wird, spart man Zeit und generell möchte man ja eher in einem Programm bleiben statt hin und her zu wechseln.
Bei SwarmUI hatte grade einen Prompt Enhancer der auf dieser "Generate Text" Node aufbaut released und in der Repo ist eine nützliche System-Prompt Sammlung dokumentiert (mit Links), also wenn man seinem LLM (egal in welcher Form) ein Preset passend zu einem Bild-Modell anhand geben möchte, dann findet man sie hier gesammelt. Ich teste mal, wie gut die Ergebnisse sind, sonst hab ich, wenn ich es benutzt habe (zb beim Pharao) qwen 3.8 27b benutzt gehabt, aber rein in LM Studio (andere LLM Schnittstellen Extension in SwarmUI wird grade überarbeitet.)
Ich nutze ein Ollama-Backend. Ich glaube kaum, dass Generate Text meinen System-Prompt händeln kann. Ich brauche schon ein Kontextfenster von 12k ^^
Und ich habe es direkt in meinem Workflow-Node,
und die Ausgabe vom Refiner geht direkt in meine P&N-Prompt-Condition-Node
(kann hier zwischen AI-Prompt und Standard umschalten).
Ich teste gerade verschiedene Modelle, aber Qwen 3.5+ ist wohl die beste Wahl.
Aktuell habe ich auch ein Qwen 3.8 27B im Test, das ist ein echtes "Beast", aber es läuft dennoch alles lokal bei mir. Und ich denke das wird das 3.5 ablösen. ^^
Ich habe heute auch mein Ollama-Backend (inklusive ROCm) ein Update verpasst und auch für ComfyUI die PyTorch-Nightly-Version (ROCm) installiert.
1. Ist damit endlich der Radeon-Idle-Bug behoben, bei dem ein Core ständig auf 80-85 % Last läuft.
2. Braucht der Workflow vom Starten bis zum Bild (inklusive Refiner) ca. 150 Sekunden. Durch den Think-Modus schwankt es manchmal ca. um plus/minus 30 Sekunden.
Ich würde sagen das kann sich sehen lassen für ein lokales 2KSampler Setup. ^^
Generate Text taugt für einen Test, für eine echte Nutzung ist es viel zu lahm.
Ich nutze ein LMStudio Backend mit Gemma 4 12B Heretic im Thinking mode und OpenAI API kompatiblen nodes…mit load / unload nodes um den VRAM zu managen.
Das ist schnell und funktioniert mit jedem Modell 👍
Das wundert mich aber, das sollte eigtl das allerschnellste sein, ok kommt vll drauf an, was verwendet wird, aber, wenn es das ist, was das Bildmodell eh verwendet? Dann muss nicht mal was Ge- und Entladen werden.
Könnte das vll lahm sein, falls man eingestellt hat, dass der Textencoder nicht in den VRAM geladen wird? Dass es dann in Deinem Fall auf CPU/RAM den Prompt erstellt hat? Ich poste gleich ein Testbild (Grid) mit verschiedenen cfg-werten von MOSS image, das Prompt davon kam aus der Implementierung von "Generate Text" in SwarmUI (frontend für comfyUI) und hat ca 3-4 Sekunden gedauert. (Eingestellt ist, den gleichen Encoder wie das Modell zu verwenden, also müsste es qwen 3.5 9b sein).
Mal verschiedene cfg Werte von 1-6 mit 1024x1024 mit MOSS Image und 30 Steps getestet. Samper: Euler/ Scheduler: Simple
A close-up portrait photograph of a young man named Victor, featuring warm natural lighting that highlights his expressive eyes and subtle smile. He has short dark hair with a slight tousle, wearing a casual navy blue crew-neck sweater over a white t-shirt. The background is a softly blurred urban street scene with hints of brick architecture and bokeh from distant lights, creating a shallow depth of field that keeps the focus entirely on his face. The image captures an intimate, candid moment with a slightly grainy film aesthetic, rich earth tones, and a mood of quiet confidence.
Edit2: Anbei noch ein Video zu MOSS Image, wo auch die Verwendung mit Bounding Boxes in comfyUI gezeigt wird, man muss auf das neurere Node System umschalten, damit das in dem Fall funktioniert (wird in dem Video auch gezeigt).
YouTube
An dieser Stelle steht ein externer Inhalt von YouTube, der den Forumbeitrag ergänzt. Er kann mit einem Klick geladen und auch wieder ausgeblendet werden.
Das wundert mich aber, das sollte eigtl das allerschnellste sein, ok kommt vll drauf an, was verwendet wird, aber, wenn es das ist, was das Bildmodell eh verwendet? Dann muss nicht mal was Ge- und Entladen werden.
Könnte das vll lahm sein, falls man eingestellt hat, dass der Textencoder nicht in den VRAM geladen wird? Dass es dann in Deinem Fall auf CPU/RAM den Prompt erstellt hat?
Für einen simplen Use Case wie für Moss (Kleines TextEncoder Modell, kein Thinking Mode, sehr simpler System Prompt für den Prompt Enhancer) fällt das nichts ins Gewicht.
Sobald man sich aber an etwas besserem wie eben Gemma 4 12B im Thinking Mode versucht, merkt man schnell, dass die LM Studio Inference etwa 10x schneller ist.
Ich umgehe grundsätzlich die Prompt Enhancer und ersetze sie durch meine eigenen mit eben Gemma 4 12B als Backend.....das ist meiner Meinung nach aktuell das schnellste und kompetenteste lokale Model, dass auf meiner 5070Ti komplett im VRAM läuft.
Ich nutze die OpenAI / LM Studio nodes auch für andere Use-Cases, z.b. das Reverse-Engineering von Bild-zu-Prompt, das geht erst mit Thinking mode richtig gut.
Noch ein Standard Use-Case ist Prompt modification, also eine Anpassung eines existierenden Prompts mit einer Change Anweisung (Passe Style auf xyz an, lass die Charaktere was anderes tun, ersetzte Hintergrund, normalisiere das Format auf irgendwas....sozusagen Edit-Mode auf Prompt level)
Was Moss angeht:
Hab's auch etwas getestet...und es als in Belangen schlechter als Krea 2 empfunden. Krea 2 (Finetunes) ist momentan für mich der Goldstandard der lokalen Bild-Generierungs-Modelle...Qwen 2.1 ist auch grottig, Flux 3 klein taugt für Generierung auch nix, macht aber als Edit / Upscaler einen sehr guten Job...fehlt nur noch ein gescheiter NSFW LORA
Klar ist das überlegen und ich empfehle das auch anhand zu haben, also ein unzensiertes, gutes lokales LLM in LM Studio/ oder ähnlich, nutze ich selbst ja auch. Aber um eben mal einen Prompt für Spielereien etwas zu "enhancen" (ohne das verschiedene Modelle geladen werden) ist das schon recht praktisch mit Generate Text, sofern es sehr schnell funktioniert versteht sich, bzw. für Leute, die sich noch nicht weiter damit beschäftigt haben und noch kein eigenes LLM Programm haben.
Bei Flux3 habe ich auch gelesen, keine Ahnung ob es stimmt, dass sie nachträglich NSFW Content versucht haben zu entfernen (also aus der Basis, aus der sie das entwickelt haben) und dass das dazu beigetragen haben soll, dass die Qualität bzgl. Anatomie usw. sich verschlechtert hat. Das Modell ist nicht in allem schlecht (wie manche sagen), aber vll auch etwas zu klein - wobei MOSS zeigt, dass es auch mit 5B schon mehr (aber eher inhaltlich ^^) machbar ist, also sie hätten wsl. besser die Größe von Flux2Klein beibehalten, dann wäre die Qualität womöglich gleich oder besser und die Verbesserungen auch vorhanden. Einer der Coder von MOSS sagte übrigens bei einem AMA in Reddit, dass sie evtl noch eine "Big" Version von dem Model rausbringen würden, das wäre auch sehr interessant
Edit2: Anbei noch ein Video zu MOSS Image, wo auch die Verwendung mit Bounding Boxes in comfyUI gezeigt wird, man muss auf das neurere Node System umschalten, damit das in dem Fall funktioniert (wird in dem Video auch gezeigt).
Ich hab das mit den Bounding Boxes im neuen ComfyUI Template zu MOSS ausprobiert und irgendwie scheint es bei mir kein effekt zu haben wenn ich die Boxen mit dem Text verschieb!
Iwie steig ich da noch nicht ganz durch. Allerdings hatte ich auch auf die schnelle keine lust mich durch englischsprachigen Techblublub Videos zu quälen!


 Zuerst hatte ich nur die Idee vom Pharao, auf einem Thron, dann kam mir die Katze in den Sinn, dann dass der Thron natürlich auch eine Art Maschine ist usw.. aber die Steampunk Lora machte bei Werten über 0.2/0.3 immer Uhren aus den z.B. leuchtenden Monokeln und ähnlichen Bestandteilen. Sie macht das Bild auch etwas dunkler bzw. düsterer, aber bringt ganz gut Metall und Oberflächen davon, sowie Maschinen-Stil rein.