
Du verwendest einen veralteten Browser. Es ist möglich, dass diese oder andere Websites nicht korrekt angezeigt werden.
Du solltest ein Upgrade durchführen oder einen alternativen Browser verwenden.
Du solltest ein Upgrade durchführen oder einen alternativen Browser verwenden.
[Sammelthread] AI - Bildgenerierung (Stable Diffusion, Midjourney & Co)
- Ersteller MechanimaL
- Erstellt am
samuelclemens
Lt. Commander
- Registriert
- Nov. 2017
- Beiträge
- 1.644
Man muss das Material also vorher entsprechend vorbereiten und taggen!?
Das macht es aufwändiger. Ich dachte man könnte einfach da Videos und Bildersammlungen reinsemmeln.... 🤔
Das macht es aufwändiger. Ich dachte man könnte einfach da Videos und Bildersammlungen reinsemmeln.... 🤔
- Registriert
- Nov. 2005
- Beiträge
- 1.301
Es gibt schon Programme/Workflows die einiges an Arbeit automatisieren, aber du musst dennoch schon noch ein wenig selbst machen. Schau z.B. mal nach "AI Toolkit" (Lora Tutorial).samuelclemens schrieb:Man muss das Material also vorher entsprechend vorbereiten und taggen!?
Das macht es aufwändiger. Ich dachte man könnte einfach da Videos und Bildersammlungen reinsemmeln.... 🤔
- Registriert
- Nov. 2005
- Beiträge
- 1.301

Das heißt, man ist auf div. Seiten angewiesen, wo das geht. Aber halt mit Kosten (Abos bzw Einmalzahlungen)qualle schrieb:Wenn man aufhttps://civitai.com/modelsnach "nude" oder "uncensored" sucht, kommt ein Warnhinweis:
Anhang anzeigen 1735716
Also nein, ich denke, das geht mittlerweile nicht mehr. Zumindest nicht direkt.
Ergänzung ()
Du meinst, mit welcher Hardware?MechanimaL schrieb:Am meisten (lokal) verwendet wird wohl aktuell LTX2.3, damit kannst Du schon so einiges erreichen. Tools: comfyui oder wangp. Es gibt auch viele zusätzliche Mittel und Methoden, um deutlich mehr rauszuholen, als die reine Anwendung des Basismodels hergibt. Ist halt etwas zeitaufwendiger sich in alles reinzufuchsen im Vergleich zu ner Website wie Kling und ein gewisses Maß, insb. an VRAM/RAM, sollte vorhanden sein, um Qualität bzw. einigermaßen schnell Ergebnisse zu erhalten. Mit was bist Du unterwegs?
Einfach .red statt .com eingeben bei civitai
Leider "nur" mit RTX 5090 + 9950X3D + mageren 32GB System-RAM (eine zweite 5090 habe ich auch noch, aber die reißt es wahrscheinlich nicht arg heraus). Für Gaming top, aber für AI-Kram auf Kling AI-Niveau nicht ausreichend bzw. zu langsam

Mit der viel niedrigeren Rechengeschwindigkeit könnte ich mich noch "anfreunden", insofern die Qualität der von Kling AI + uncensored Content entsprechen würde. Aber das wird wohl ein Wunschtraum bleiben, weil damit (uncensored Content) nen Haufen Geld zu machen wäre. Daran hätte ich nicht mal Interesse - mir reicht es für den Hausgebrauch
btw:
Was ich mit Kling AI machen konnte, ist in meinen Augen schon eindeutig 18+ Material. Also schon eindeutiger Content. Erschreckend, dass nicht mal ich - der das erstellt hat - erkennen kann, dass das alles nie wirklich passiert ist, aber alles bis ins Detail wahnsinnig real aussieht 🫤
Zuletzt bearbeitet:
Bin bei YT gerade über eine KI-Restaurierung gestoßen:

... ist tatsächlich so geschehen, wurde dann aber nachbearbeitet.
---
https://civitai.red/ wurde doch schon genannt. Dafür muss man aber dort angemeldet sein und bestimmte Modelle kosten etwas... Habe das mal gemacht, und allem, außer Gewalt und Politik, zugestimmt. Auf bestimmte politische Symbole kann ich verzichten. Das Ganze wirkt täuschend echt.
YouTube
An dieser Stelle steht ein externer Inhalt von YouTube, der den Forumbeitrag ergänzt. Er kann mit einem Klick geladen und auch wieder ausgeblendet werden.
Ich bin damit einverstanden, dass YouTube-Embeds geladen werden. Dabei können personenbezogene Daten an YouTube übermittelt werden. Mehr dazu in der Datenschutzerklärung.
... ist tatsächlich so geschehen, wurde dann aber nachbearbeitet.
---
Casius.A schrieb:Das heißt, man ist auf div. Seiten angewiesen, wo das geht. Aber halt mit Kosten (Abos bzw Einmalzahlungen)
https://civitai.red/ wurde doch schon genannt. Dafür muss man aber dort angemeldet sein und bestimmte Modelle kosten etwas... Habe das mal gemacht, und allem, außer Gewalt und Politik, zugestimmt. Auf bestimmte politische Symbole kann ich verzichten. Das Ganze wirkt täuschend echt.
- Registriert
- Nov. 2005
- Beiträge
- 1.301
Also manchmal gibts Modelle, die erst nach einer Zeit freigeschaltet werden (zum kostenlosen Download), aber soweit ich weiß, sind Modelle auf civitai generell kostenlos, das Generieren damit auf der Seite kostet halt was. Es gibt neben huggingface noch
civarchive.com (verlinkt auf weitere seiten)
Zuletzt bearbeitet:
- Registriert
- Nov. 2005
- Beiträge
- 1.301
LTX Director 2.0
YouTube
An dieser Stelle steht ein externer Inhalt von YouTube, der den Forumbeitrag ergänzt. Er kann mit einem Klick geladen und auch wieder ausgeblendet werden.
Ich bin damit einverstanden, dass YouTube-Embeds geladen werden. Dabei können personenbezogene Daten an YouTube übermittelt werden. Mehr dazu in der Datenschutzerklärung.
samuelclemens
Lt. Commander
- Registriert
- Nov. 2017
- Beiträge
- 1.644
Jemand paar Tipps wie man zb beim generieren von Comicpanels oder Storyboards den Text in Sprechblasen korrekt hinbekommt?
KI nur für Dinge benutzen, die KI auch kann. Eine Sprechblase ist kein integraler Bestandteil eines Bildes, muss also nicht perspektivisch oder farblich in das Bild passen. Hier kann man das Gleiche tun, was man bei einem Foto auch machen würde. Mit einem normalen Malprogramm als letztem Bearbeitungsschritt die Sprechblasen hineinmalen. So kann man deren Größe, Font und Farbe einheitlich über alle Bilder hinweg passend gestalten. Man KANN im Winter draußen in Sandalen herumlaufen, man MUSS aber nicht.
samuelclemens
Lt. Commander
- Registriert
- Nov. 2017
- Beiträge
- 1.644
ChatGPT schafft das mit dem Text und Sprechblasen inzwischen sehr gut.
Leider gelingt es mir offline mit ComfyUI bisher so gar nicht.
Die Sprechblasen an sich oder die Darstellung von Text ist dabei auch kein Problem. Nur anscheinend die Grammatik oder der Inhalt an sich nicht.
Selbst wenn ich den Inhalt der Sprechblasen exakt vorgebe kommt nur Kauderwelsch dabei raus das nur entfernt der Vorgabe ähnelt.
Leider gelingt es mir offline mit ComfyUI bisher so gar nicht.
Die Sprechblasen an sich oder die Darstellung von Text ist dabei auch kein Problem. Nur anscheinend die Grammatik oder der Inhalt an sich nicht.
Selbst wenn ich den Inhalt der Sprechblasen exakt vorgebe kommt nur Kauderwelsch dabei raus das nur entfernt der Vorgabe ähnelt.

Keuleman
Lieutenant
- Registriert
- Aug. 2014
- Beiträge
- 584
@MechanimaL Nutzt Du den LTX Director? Gestern gesehen und überlegt, ob ich mir den als Alternative zu meinen Workflows reinziehen muss :-)
- Registriert
- Nov. 2005
- Beiträge
- 1.301
Ich hab länger nix mit Video gemacht, beobachte nur die Entwicklung. In nem anderen Video hieß es, der Director verschlechtere etwas die Qualität. Woran es liegt usw. konnte aber nicht rausgestellt werden. Ist auf jedenfall ein interessantes Tool, aber wie man das Optimum rausholt kann ich jetzt mangels praxiserfahrung dazu nicht sagen.
Wenn du magst kannst du mal ein Beispiel schicken, was du gemacht hast womit usw. (inkl. Bild).
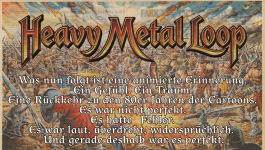
Womit versuchst Du es? Es gibt Modelle, die das eingermaßen können und andere garnicht. Wenn du eines benutzt, dass es eher gut kann, kannst Du mit Inpainting nur den Bereich markieren und dann den Text neu generieren lassen und beim inpainting muss man sagen, dass nur dieser Bereich betrachtet werden soll (das hat in verschiedenen Tools unterschiedliche Bezeichnungen), dann sieht das Modell mit der vollen Auflösung nur den kleinen Ausschnitt und kann den Text reparieren/neu erzeugen.samuelclemens schrieb:Die Sprechblasen an sich oder die Darstellung von Text ist dabei auch kein Problem. Nur anscheinend die Grammatik oder der Inhalt an sich nicht.
Wenn du magst kannst du mal ein Beispiel schicken, was du gemacht hast womit usw. (inkl. Bild).
- Registriert
- Nov. 2005
- Beiträge
- 1.301
👍Ideogram4 ist die aktuell beste Wahl bei Text und open weights/source. Für Überschriften tuns auch andere und bei englischem (oder ggf. chinesischem) Fließ-Text / extra Text mags auch mit manch anderen Modellen noch ganz gut klappen (zb Boogu, Qwen image).
Nur fürs Prompting braucht man bei Ideogram halt (idealerweise) Hilfsmittel wegen der erwarteten JSON Prompts, dafür bindet man z.B. direkt ein Sprachmodell ein, dass die Umwandlung direkt macht, wie in diesem Workflow (inkl. KJs Ideogram Prompt Builder).
Oder man nutzt außerhalb von comfyui eines, lokal oder online, das ein entsprechendes Systemprompt zur korrekten Umwandlung hat, fertig auch bspw. bei chatgpt zu finden.
Nur fürs Prompting braucht man bei Ideogram halt (idealerweise) Hilfsmittel wegen der erwarteten JSON Prompts, dafür bindet man z.B. direkt ein Sprachmodell ein, dass die Umwandlung direkt macht, wie in diesem Workflow (inkl. KJs Ideogram Prompt Builder).
Oder man nutzt außerhalb von comfyui eines, lokal oder online, das ein entsprechendes Systemprompt zur korrekten Umwandlung hat, fertig auch bspw. bei chatgpt zu finden.
Zuletzt bearbeitet:
samuelclemens
Lt. Commander
- Registriert
- Nov. 2017
- Beiträge
- 1.644
Die besten Ergebnisse erzielte ich bisher mit Qwen Image 2512 was die Grafik und Bildkomposition angeht.
Z-Image Turbo hingegen macht erstaunlicherweise die wenigsten Textfehler, lässt aber hier und da Ganze Sprechblasen/ Dialogteile weg.
Ich versuche es mal mit Ideogram. Dauert aber ne weile alles runterzuladen.
Mit Inpaint und Masken hab ich bisher kaum gearbeitet.
Interessant an Storyboards oder Comicpanelen ist das die KI hier hier inzwischen die Konsistenz/Kontinuität gut beherrscht als wenn man versucht verschiedene zusammenhängende Einzelbilder zu generieren.
Ich habe es noch nie mit Fotorealsimus probiert aber auf diese art könnte man ganz gut auch Videos angehen. wobei dann jedes Panel als Zwischenframe fungiert im Workflow. Zumindest ist so ein Storyboard schneller generiert als ein ganzen Video und lässt sich beliebig anpassen.
Edit: Ideogram scheint wirklich sehr viel besser mit Text klarzukommen!
Z-Image Turbo hingegen macht erstaunlicherweise die wenigsten Textfehler, lässt aber hier und da Ganze Sprechblasen/ Dialogteile weg.
Ich versuche es mal mit Ideogram. Dauert aber ne weile alles runterzuladen.
Mit Inpaint und Masken hab ich bisher kaum gearbeitet.
Interessant an Storyboards oder Comicpanelen ist das die KI hier hier inzwischen die Konsistenz/Kontinuität gut beherrscht als wenn man versucht verschiedene zusammenhängende Einzelbilder zu generieren.
Ich habe es noch nie mit Fotorealsimus probiert aber auf diese art könnte man ganz gut auch Videos angehen. wobei dann jedes Panel als Zwischenframe fungiert im Workflow. Zumindest ist so ein Storyboard schneller generiert als ein ganzen Video und lässt sich beliebig anpassen.
Leider lassen die Privatnachrichten keine Bilder oder andere Dateien zu und ich mag nicht Teile dieser Kurzgeschichte hier veröffentlichen.MechanimaL schrieb:Wenn du magst kannst du mal ein Beispiel schicken, was du gemacht hast womit usw. (inkl. Bild).
Edit: Ideogram scheint wirklich sehr viel besser mit Text klarzukommen!
Zuletzt bearbeitet:
- Registriert
- Nov. 2005
- Beiträge
- 1.301