[Sammelthread] AI - Bildgenerierung (Stable Diffusion, Midjourney & Co)

CountSero schrieb:
@RyzA ich habe mich mal von deinem Bild inspirieren lassen ^^
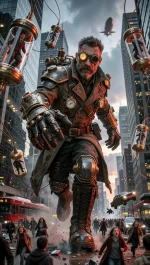
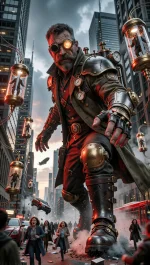
@CountSero ich habe mal Deinen Prompt durch meine GraKa gejagt.
diffusion-200283.png

Anschließend hat meine LLM das Prompt für Dreamshaper XL optimiert.
diffusion-487477.png

Colossal steampunk soldier, giant scale, towering over city street, extreme worm's eye view, looking up. [Subject: weathered face, handlebar mustache, amber goggles, heavy canvas coat, brass buttons, steel pauldrons, pressure gauges]. [Action: reaching huge hand toward camera, striding forward]. [Environment: modern skyscrapers, dense downtown canyon, hazy distance, airship in sky, overcast with golden sun rays]. [Foreground: hundreds of tiny fleeing people, debris, red bus, smoke and dust]. [Surreal elements: floating glass canisters with humans inside, copper cables]. [Style: cinematic lighting, high contrast, rim light, volumetric fog, deep copper and gray tones, photorealistic film still, shallow depth of field, sharp focus on face and hand].

So nun bin ich aber auf Dein Bild gespannt!
 
  • Gefällt mir
Reaktionen: RyzA
eigentlich mach ich das ungern aber bitte ^^
 

Anhänge

  • Random -0007.webp
    Random -0007.webp
    306,5 KB · Aufrufe: 48
  • Gefällt mir
Reaktionen: RyzA und AndreasF1975
Ich finde es immer wieder sehr interessant was für teilweise stark unterschiedliche Interpretationen auch des selben Prompts herauskommen.
 
Das hängt ja stark vom genutzten Modell ab und wie du deinen Workflow optimiert hast. (Ich nutze z.B. ComfyUI)

Ich nutze z. B. zwei KSampler in Reihe > der erste arbeitet mit 14 Steps bei CFG 1.0 und Denoise 1.0 (LoRAs lasse ich mal weg, sind aber dafür da, dass mehr Realität und Prompt-Genauigkeit übernommen werden) und der zweite ist für mich als Refiner/Upscaler tätig, der läuft mit 8 Steps, CFG 1.2 und einem Denoise von 0.5 (auch hier hängt eine LoRa dran für die Prompt-Genauigkeit).

Das macht dann schon einen Unterschied, aber das Bild rendert dann auch mal eben ca. 300 Sekunden bei mir.

Dann kommt hinzu, dass ich zwar ein FP8-scaled-Modell verwende, aber beim Laden des Diffusion-Modells mit einer Custom Node sage, dass die Berechnungen in FP16 stattfinden, das macht dann auch einen Unterschied usw.

Hier der gleiche Prompt noch mal, aber mit einem Model Shift von 5.5 (geregelt über eine spezielle Node). Bildlich gesprochen sagt man der KI damit, wie "aggressiv" oder in welcher Phase sie sich auf die Bilddetails stürzen soll, was den Look noch mal komplett verändern kann.
 

Anhänge

  • Random -0016.webp
    Random -0016.webp
    310,1 KB · Aufrufe: 48
  • Gefällt mir
Reaktionen: AndreasF1975
Kann mir einer genau erklären wie man bei einem Style LoRa Training beim Captioning genau vorgehen muss?
Zb bei ausgefallenen Körperschmuck oder zb Gesichstätowierungen.
Beim Charakterlora hab ich ja immer paar Dutzend Bilder mit der selben Person in verschiedenen Ansichten und Outfits. Aber das Gesicht bleibt gleich. Alles was austauschbar sein soll auf dem Bild wird beschrieben und zusätzlich ein Triggerworte vergeben das überall drin steht.
Aber wie mache ich es korrekt bei einer Auswahl an Bildern mit verschiedenen Personen in verschiedensten Ansichten, Outfits usw wo das einzig gemeinsame zb Augenbrauenpiercings sind!?
 
CountSero schrieb:
eigentlich mach ich das ungern aber bitte ^^
und welches Modell hast du verwendet?

@samuelclemens habe ich noch nicht gemacht, aber nicht nach der gleichen Logik, die Du ja schon geschildert hast? Also zb das Piercing nicht extra beschreiben, aber alles andere.
 
MechanimaL schrieb:
Also zb das Piercing nicht extra beschreiben, aber alles andere.
Gesichter sind sehr schwer genau zu beschreiben.
Ich habe es auch mit Ausschnitten versucht die nur Augenbrauen zeigt und das in der caption hinterlegt. Hat's auch nicht gebracht.
Bei Tattoos wird's noch schlimmer weil es unendlich viele Motive gibt sie sich aber im Gesicht visuell ganz anders verhalten als an den üblichen Stellen.
 
leboef schrieb:
Aber ich weiß ja, dass deine Eigenleistung bei diesem Bild nur sehr gering ist. Dementsprechend ist dieses Bild für mich wertlos.
Ja so ging es mir vor einigen Jahren mit der digitalen Photographie welche ich praktisch an den Haken gehängt habe. Ernsthafte Photos mache ich nur noch auf SW Film und entwickel diese in der eigenen Dunkelkammer. Die Automatisierung sowohl der Kameras als auch insbesondere der Software zum entwickeln nahm für mich beängstigende Formen an. Was anfangs noch äußerst interessant war und viele neue Möglichkeiten aufzeigte hat seinen Reiz verloren. Bei digitalen Bildern kann man nicht sicher sein was davon real oder durch Photoshop erstellt bzw korrigiert wurde. Hintergründe/Himmel austauschen, störende Objekte verschwinden lassen etc. Grundsätzlich ja für mich wertlos.

Die Möglichkeit schnell ein passenden Photo zum Beispiel für sein Gewerbe oder einen Internetauftritt zu erstellen ohne sich durch Stockphoto Seiten zu wühlen und doch nicht das passende zu finden hat durchaus etwas. Keine Persönlichkeitsrechte, Urheberrechte oder Lizenzprobleme.

Es ist ein weiteres Werkzeug. So wie die Kamera auch. Für mich fühlt es sich falsch an wenn an einem Tag hunderte Bilder auf das Speichermedium wandern und diese per Batch verarbeitet werden. Ich glaube es ist nur noch ein ganz kleines Stück bis zur Motivklingel. Für mich ist der Auslöser nur einer der ersten Schritte und endet wenn das Bild gewässert ist. Die Ki Bildgenerierung ist ein weiteres Werkzeug von vielen. Ich kann es verstehen wenn man es für wertlos hält. Derzeit finde ich sie sehr interessant und ich muss zugeben interessanter als eine meiner digitalen Kameras aus dem Schrank zu holen. Da greife ich derzeit lieber zu einer meiner Wechselsensoren-Kameras.


Das kann übrigens kein Wildlife Photograph:
Quagga.jpg
 
  • Gefällt mir
Reaktionen: RyzA
Ich halte mich auch nicht für einen Künstler oder Prompt-Artist. Ich könnte so etwas selbst nie irgendwie zeichnen oder mit anderen Tools darstellen. Ich habe mich hier über ein paar Wochen in die Thematik eingearbeitet und mich darauf eingelassen.

Habe nun einige Custom Nodes für ComfyUI erst per Vibe-Coding erstellt und später auch ein paar selber geschrieben, weil ich von den anderen gelernt habe. Das hat meinen Workflow enorm vereinfacht und verschlankt. Manchmal bin ich evtl. über das Ziel hinausgeschossen, weil ich hier Nodes mit direkter Anbindung an eine SQL-Datenbank erstellt habe, aber der Weg war ja auch, dabei etwas zu lernen. Ich habe mittlerweile auch mein Ollama-Backend mit ComfyUI verknüpft und sicher über Wochen an guten System-Prompts gearbeitet, damit der AI-Prompt-Enhancer so arbeitet, wie ich es mag. Das, was dabei herauskommt, ist nur die Basis, aber es nimmt einem schon sehr viel Arbeit ab. Dann braucht man auch eine Sammlung (so was wie ein Cheat Sheet), wo man sich die Basis für Styles sammelt, wie z. B. so was:

Retro-Futurismus (Atom Age / 1950s Sci-Fi)

  • Vibe: Zukunftsvision der 50er/60er Jahre, Chrom, geschwungene Googie-Linien, Raketen-Ästhetik, Pastellfarben, Bubble-Helme.
  • Keywords zum Einfügen: retro-futuristic 1950s atom age style, gleaming chrome, curved googie architecture, vintage space-age aesthetic, pastel colors, clean lines and optimistic retro vibe.
Wenn man sich so was nach und nach anlegt, kann man schnell nach dem gewünschten Style ein Bild erstellen. Ich habe mir eine Liste nach und nach erstellt und verbessert. Natürlich muss man hierfür recherchieren, was so einen Style ausmacht. Aber wenn man dann seine Basis hat, fasst man das am besten in ein paar Basispunkten auf Englisch zusammen. Natürlich ist es auch vom Model abhängig was man für Ergebnisse erhält.

Dann bekommt man schnell auch so was zusammen gestellt im SteamPunk Style ^^

Random -0092.webp


braindamage10k schrieb:
Erstellt mit ChatGPT. Cyberpunk is einfach cool. ^^

Stimmt so ein Cyberpunk Diorama hat was ;) Ok, Mal Spaß bei Seite, ja Cyberpunk Style hat was aber ich habe mich irgendwie etwas satt gesehen, das Spiel CP2077 mag ich sehr Spiele ich auch gern^^ Es für mich aber SteamPunk oder BioPunk im Moment interessanter. Hoffe es war Ok für dich das ich mich an deinem Bild Orientiert habe ^^

Random -0088.webp


MechanimaL schrieb:
und welches Modell hast du verwendet?

Ist ein KREA2 Turbo FP8 Scaled Modell, das ich halt durch meinen Workflow an meine Wünsche angepasst habe.
 
  • Gefällt mir
Reaktionen: braindamage10k, AndreasF1975 und RyzA
Rothaarige Elfenkriegerin auf schwarzen Pferd. Auch mit der kostenlosen Version von ChatGPT erstellt.

ChatGPT Image 24. Sept. 2026, 09_04_47.png
 
  • Gefällt mir
Reaktionen: braindamage10k, CountSero und AndreasF1975
Na da werfe ich doch mal ein wenig Sci-Fi in den Raum.
diffusion-268367.png

A wide cinematic shot of a futuristic space station's observation deck. In the foreground, a woman with teal metallic face-plating, gold filigree, and glowing cyan eyes stands looking out through a massive, curved panoramic window. The interior of the station is sleek and dimly lit with amber accents. Outside the window, a colossal planet dominates the background, showing atmospheric clouds and surface details. Visible orbital structures and docking bays are attached to the station. High-contrast lighting, photorealistic film still, 8k resolution, deep space atmosphere, cinematic color grading.
diffusion-8367d.png

A breathtaking wide-angle shot of a solitary woman with steampunk-cybernetic enhancements standing at the edge of a space station's observation deck. Full body visible, she is dwarfed by the scale of the massive planet looming in the background through a giant window. The teal and gold details of her mechanical face and headpiece glint under the amber interior lights. Detailed textures on her clothes and the metallic walls of the station. Cinematic color grading, 8k, sharp focus on both the character's full form and the distant planetary surface.


Pinokino - DreamShaperXL - Lokal auf Arc B50Pro


Das zusammenspiel mit meiner LLM, Gemma-4-12B-It-Qat-GGUF, welche ich unter JAN laufen lasse klappt sehr gut. Diese kann Bilder/Photos auswerten Analysieren und einen Promt somit aus vorlagen erstellen. Ohne das ich die Ergebnisse der KI zeige kann diese nur aus meiner Beschreibung Verbesserungen zum Prompt vorschlagen. Das klappt außerordentlich gut. Zwar nicht die Kommunikation wie bei Chat GPT bis man das gewünschte Bild hat aber wie ich finde sehr gut und ohne Beschränkung.
Was ich wirklich gut finde ist das ich das wie die LLM was umsetzt lesen kann. Das ist wie ich finde sehr lehrreich. Ebenso die Hinweise zu den Prompt bzw die Veränderungen und worauf man beim erstellen achten sollte je nach Modell. Das bietet mir Chat GPT so nicht. Chat GPT hat ja sein Frei Volumen arg beschränkt. Verständlich wenn auch schade.
Derzeit bin ich aber mit meinem Workflow sehr zufrieden. Nur die Zeit, die Zeit habe ich derzeit kaum.
 
  • Gefällt mir
Reaktionen: RyzA und CountSero
Hier auch noch ein wenig SciFi:

ChatGPT Image 26. Sept. 2026, 10_05_16.png

Ein Astronaut mit Blick aufs schwarze Loch.
 
  • Gefällt mir
Reaktionen: CountSero
AI Cyber-Gottheit und ihre Untertanen

Thronsaal der kybernetischen Gottheit.png
 
  • Gefällt mir
Reaktionen: AndreasF1975 und CountSero
CountSero schrieb:
Ich halte mich auch nicht für einen Künstler oder Prompt-Artist. Ich könnte so etwas selbst nie irgendwie zeichnen oder mit anderen Tools darstellen. Ich habe mich hier über ein paar Wochen in die Thematik eingearbeitet und mich darauf eingelassen.

Habe nun einige Custom Nodes für ComfyUI erst per Vibe-Coding erstellt und später auch ein paar selber geschrieben, weil ich von den anderen gelernt habe. Das hat meinen Workflow enorm vereinfacht und verschlankt. Manchmal bin ich evtl. über das Ziel hinausgeschossen, weil ich hier Nodes mit direkter Anbindung an eine SQL-Datenbank erstellt habe, aber der Weg war ja auch, dabei etwas zu lernen. Ich habe mittlerweile auch mein Ollama-Backend mit ComfyUI verknüpft und sicher über Wochen an guten System-Prompts gearbeitet, damit der AI-Prompt-Enhancer so arbeitet, wie ich es mag. Das, was dabei herauskommt, ist nur die Basis, aber es nimmt einem schon sehr viel Arbeit ab. Dann braucht man auch eine Sammlung (so was wie ein Cheat Sheet), wo man sich die Basis für Styles sammelt, wie z. B. so was:


Wenn man sich so was nach und nach anlegt, kann man schnell nach dem gewünschten Style ein Bild erstellen. Ich habe mir eine Liste nach und nach erstellt und verbessert. Natürlich muss man hierfür recherchieren, was so einen Style ausmacht. Aber wenn man dann seine Basis hat, fasst man das am besten in ein paar Basispunkten auf Englisch zusammen. Natürlich ist es auch vom Model abhängig was man für Ergebnisse erhält.

Dann bekommt man schnell auch so was zusammen gestellt im SteamPunk Style ^^

Anhang anzeigen 1766604


Stimmt so ein Cyberpunk Diorama hat was ;) Ok, Mal Spaß bei Seite, ja Cyberpunk Style hat was aber ich habe mich irgendwie etwas satt gesehen, das Spiel CP2077 mag ich sehr Spiele ich auch gern^^ Es für mich aber SteamPunk oder BioPunk im Moment interessanter. Hoffe es war Ok für dich das ich mich an deinem Bild Orientiert habe ^^
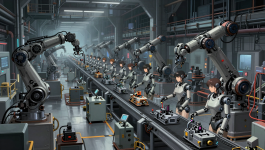
Anhang anzeigen 1766603


Ist ein KREA2 Turbo FP8 Scaled Modell, das ich halt durch meinen Workflow an meine Wünsche angepasst habe.
Steampunk is auch geil. Siehe mein Avatar.
ef33a07e-e8f4-4bba-843f-75e086429cf6.png

Ich bin auch großer Ghost in the Shell Fan. Und meine Lieblingsband ist eine Steampunk Metalband. ^^
 
  • Gefällt mir
Reaktionen: RyzA, CountSero und AndreasF1975
Mensch, grad heute bisschen rum überlegt, was ich mal als nächstes so basteln könnte und auch voll Lust auf was Cyberpunkiges gehabt.
 

Anhänge

  • Z-Image_Turbo_00008_.png
    Z-Image_Turbo_00008_.png
    3 MB · Aufrufe: 30
  • Gefällt mir
Reaktionen: RyzA, braindamage10k und CountSero
braindamage10k schrieb:
Steampunk is auch geil. Siehe mein Avatar.

Ich bin auch großer Ghost in the Shell Fan. Und meine Lieblingsband ist eine Steampunk Metalband. ^^
Steam Punk ist nice auch mag ich den Style von Ghost in the Shell aber war bis jetzt mit meinen Kreationen bzw. mit deren Umsetzung nie zu 100% überzeugt.
 

Anhänge

  • Random-0141.webp
    Random-0141.webp
    164,7 KB · Aufrufe: 25
  • Random-0142.webp
    Random-0142.webp
    134,3 KB · Aufrufe: 29
  • Gefällt mir
Reaktionen: AndreasF1975 und RyzA
Ein Steampunk Bild kann ich Morgen auch mal probieren.

Hier noch ein Cyberpunk-Moonwalk:

ChatGPT Image 25. Sept. 2026, 09_58_54.png
 
  • Gefällt mir
Reaktionen: AndreasF1975 und CountSero
braindamage10k schrieb:
Ich bin auch großer Ghost in the Shell Fan.
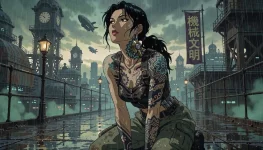
Ok eine Gute Formel für eine Ghost in the Shell Ästhetik ist gar nicht so einfach zu finden ^^

Ich habe nochmal versucht dein Vorlage in Ghost in the Shell Optik zu bringen ^^

Random-0187.webp


hier ein andere Ansatz:

Random-0196.webp


hoffe gefällt ^^ mit dem ersten bin ich "recht" zufrieden das zweite hat noch Potential ^^
 
  • Gefällt mir
Reaktionen: AndreasF1975 und RyzA
Zurück
Oben