Du verwendest einen veralteten Browser. Es ist möglich, dass diese oder andere Websites nicht korrekt angezeigt werden. Du solltest ein Upgrade durchführen oder einen alternativen Browser verwenden.
NewsAMD Medusa Point: Sample-Flut mit 6, 8 und 10 Kernen bei Geekbench
Dass sich die neue APU-Familie Medusa Point von AMD mit großen Schritten dem Markt nähert, zeigt sich daran, dass diverse Lenovo-Systeme mit dieser Chip-Familie im Geekbench-Browser aufgetaucht sind. Gleich vier verschiedene Samples mit 6, 8 oder 10 Kernen wurden getestet.
Die letzten Mainstream-APUs hatten ja alle keinen InfinityCache. Vielleicht ist das auch einfach eine Erklärung: Nix da mit cleveren Portfoliogedanken, sondern das Sparbrötchen wird einfach fortgesetzt...
...ich fand schon immer, dass sich AMD zu sehr auf GPU-Seite ihrer APUs ausruht und tatsächlich haben sie ja so die Möglichkeit gegeben, dass Intel zurückschlagen konnte.
Wenn die GB7 Werte stimmen, wäre das ja deutlich weniger als beim M6. Eher das 2 Jahre alte M4 Niveau. Ja ich weiß, das ist wieder Apple mit Birnen vergleichen.
Strix Halo existiert. Natürlich dürfen APUs nahe an den dedizierten Grafikkarten sein, sie kosten dann aber auch entsprechend. Aber AMD wäre schön blöd nur noch APUs rauszubringen, die in Geräten ab 3000€ verbaut werden. Zumal je nach Architektur die Unterschiede bei niedriger TDP minimal sind, siehe die Handhelds.
dualcore_nooby schrieb:
Wenn die GB7 Werte stimmen, wäre das ja deutlich weniger als beim M6. Eher das 2 Jahre alte M4 Niveau. Ja ich weiß, das ist wieder Apple mit Birnen vergleichen.
Vor allem Vorserie mit wahrscheinlich deutlich weniger Takt, nehme ich an. Zumindest ist das sonst immer so. Zumal in dem Einsatzgebiet ja auch TDP und Kühlung und so eine große Rolle spielen.
RDNA4 verwendet zu viele Transistoren für Raytraycing Funktionen die bei einer APU mit 4 WGP (8 CU) nicht viel bringen.
Wir werden sehen ob RDNA 3.7 RDNA 3.5 mit zusätzlichen AI Datentypen und Matrixbefehlen von RDNA4 ist oder ob RDNA 3.7 die Shader Units von RDNA4 mit der Raytracing Implementation von RDNA 3.5 ist.
Ergänzung ()
Nuklon schrieb:
Sie darf nicht zu nah an den teuren dedizierten Grafikkarten sein.
Wird bei iGPUs mit maximal 4 WGP ao oder so nicht passieren.
Ergänzung ()
dualcore_nooby schrieb:
Wenn die GB7 Werte stimmen, wäre das ja deutlich weniger als beim M6. Eher das 2 Jahre alte M4 Niveau. Ja ich weiß, das ist wieder Apple mit Birnen vergleichen.
Es gibt andere Suchbegriffe:
AuthenticAMD Family 26 Model 129: Medusa Point 1
AuthenticAMD Family 26 Model 224: Medusa Point 2
Ergänzung ()
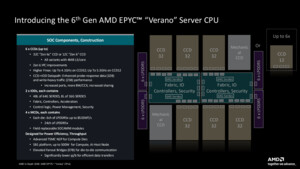
Sind es am Ende doch 3 Cluster?
Auch wenn im Geekbench nur zwei CPU-Cluster aufgeführt werden, hält die Gerüchteküche an drei Clustern fest. Für das 10-Kern-Modell wurden 4 Zen 6 + 4 Zen 6c + 2 LP vermutet. Analog dazu gibt es jetzt Mutmaßungen über Konfigurationen wie 2+4+2 für die 8-Kern-Variante und 1+3+2 für die 6-Kern-Version.
Das sehen die glaube ich die meisten im Anandtechforum nicht so. Die träumen von alle Kernen in einem CCX.
Dass es am Ende 3 Cluster sein könnten halte ich allerdings für möglich.
Ergänzung ()
3 Cluster aka 3 CCX hätte den Vorteil dass bei geringer Last komplette CCX stillgelegt werden können.
Und das ist bei Mobil APU bei denen es um möglichst lange Laufzeit an der Batterie geht ein sehr wichtiges Argument.
Im übrigen habe ich mir die hübschen Diagramme Mal genauer angesehen mit denen angeblich die Latenzen gemessen werden. Ich halte die Messwerte für kompletten Unsinn.
Es fängt damit an dass schon die Latenz zum anderen Thread auf demselben Kern sehr hoch ist.
Es geht damit weiter dass die Differenz der Latenzen zu den anderen Kernen des CCX sehr klein ist im vergleich zur niedrigesten Latenz zu einem anderen Kern.
Man sieht praktisch keine Unterschiede der Latenzen zum anderen CCX ob es auf demselben Die ist oder nicht.
Bei den Notebooks haben sich nur ein paar Enthusiasten dafür interessiert wie viele CUs die IGPU hatten.
Mangels Softwareunterstützung konnte die iGPU praktisch nur für Games verwendet werden. Wer ein Notebook zum spielen will kauft eines mit dGPU.
So betrachtet hat AMD bei Strix Point eine viel zu große iGPU verbaut, die auch dazu geführt hat dass Strix Point so teuer wurde.
CDLABSRadonP... schrieb:
...ich fand schon immer, dass sich AMD zu sehr auf GPU-Seite ihrer APUs ausruht
Intel und AMD haben jetzt halt die Rollen getauscht: Vorher wollten im Notebook „alle“ AMD CurrentGen, aber AMD konnte nicht genügend liefern, entsprechend gab es trotzdem unverdient hohe Stückzahlen für Intel. Jetzt gilt das gleiche für Intel CurrentGen...
(und ich habe sowohl Panther- als auch WildcatLake im Praxiseinsatz erlebt: Sie sind schon geil!)
Die beiden 10-Kern-Varianten (4 + 6 Kerne) werden mit 16 MB L3-Cache angegeben. Das ist gegenüber den ältesten Einträgen ein Novum. Mit dem Geekbench 6 wurde nämlich Ende April ein „AMD Plum-MDS1“ genanntes Testsystem getestet, dessen Sample die Kennung 100-000001713-30_Y trägt und laut der Datenbank stattdessen über 32 MB L3-Cache verfügt. Im Frühjahr fanden sich noch zahlreiche weitere Einträge zu potenziellen Medusa-Point-Chips mit 32 MB L3-Cache. Bei diesen wurde zudem ein höherer Basistakt von 2,4 GHz angeführt.
IIRC fand die Änderung des angezeigten L3 Caches auf nur noch 16 MByte im Juli statt.
Ich denke mit den 6 und 8 Kernvarianten ist klar, dass dies nicht der gesamte L3 Cache ist sondern sehr wahrscheinlich nur der L3 Cache des 1. Clusters. Wahrscheinlich gibt das Geekbench falsch aus.
Andererseits ist damit auch klar dass es mindestes 2 Cluster sind.
Außerdem stelle ich mir die Frage ist Medusa Point 1 wirklich monolithisch? Das ist auch der Grund warum mich die 8+2 Version des Medusa 1 so antriggert:
Wenn es nicht falsch ausgelesen ist (Cluster 1 und 2 als 1 Cluster ausgegeben) passt es nicht zur Konfiguration die für Medusa Point 1 gehandelt wird.
Der M6 ist über 50% im Singlethread voraus im Vergleich zu Strix Point. Wie will man das in einer Gen aufholen? Aktuell sieht es nach 10-15% IPC und 5% Takt aus bei Medusa. Noch dazu hat der M6 12 Kerne, Medusa je nach Lesart (zählen die LP-Kerne?) 8 oder 10.
Alle Gerüchte gegen davon aus dass bei RDNA5 der L3 Cache Geschichte ist.
Und neben viel zu viel WGP zu verbauen auch noch viel zu viel MALL zu verbauen, hätte den Strix Point noch teurer gemacht und an der Performance auch nicht genug geändert, um gegen dGPUs auch nur entfernt Lichter zu sehen.
Ergänzung ()
Philste schrieb:
Der M6 ist über 50% im Singlethread voraus im Vergleich zu Strix Point. Wie will man das in einer Gen aufholen?
Yeah. So actually, the way I've done it for my team and others is that I have a wheel of performance. And so there's, as we mentioned, instructions per cycle, how much work can you get done per cycle? There's the actual frequency attainment. And these things are opposed to each other.
The more gates you try to put in to get more work done per cycle, the lower the frequency you can actually reach. As you add more gates, the other parameters, area and power, grow. So as you try to increase single-threaded performance by doing more work per cycle, you actually make a bigger core. So then, when you want to scale out, you can't fit as many cores as you want. And you drive the power up and we're in a power-constrained environment. So you have to balance those four things: IPC, frequency, area and power.
An architect is always trying to balance those out. SMT is also an interesting one. Everybody wants strong single-threaded performance.
Dass AMD bei der Single Thread Performance zulegen will und muss ist klar. Aber AMD wird dafür die Multithread Performance nicht opfern. Da AMD eine Microarchitecture von Notebook über Desktop bis zum Server verwendet kann AMD die Kerne nicht nach belieben aufblähen. Sondern wird die IPC Stück für Stück erhöhen. So wie ich es mitbekomme bleibt den Arm Kernen momentan durch die Bank nur noch das Drehen an der Taktschraube.
Bei aller Begeisterung für die neuen Werte fürs IPhone SoC und den M6, sie sind IMO vor allem ein Indikator dass TSMC N2 ein richtig guter Prozess geworden ist. So wie N3 sehr durchwachsen war und erst mit N3E Potential ausspielen konnte.
Bei Medusa muss man nun auch berücksichtigen, dass AMD hier auf N3P setzt. Außerdem könnte hier wieder die 256 bit weite Implementierung der FPU verwendet werden.
Ein grosser Teil des Zen3-IPC-Vorteils gegenueber Zen2 kommt vom 8-Kern CCX gegenueber dem 4-Kern-CCX von Zen2. Ryzen 3300 ist deutlich besser als Ryzen 3100 aufgrund der Verwendung nur eines CCX. Von daher wuerde es mich wundern, wenn AMD einen Zehn-Kerner mit drei CCX bauen wuerde. Zwei CCX koennte ich mir noch vorstellen: ein 8er-CCX, wenn Performance gebraucht wird, und ein 2er-CCX fuer wenig fordernde Daueraufgaben.
Glaube ich nicht, deshalb amüsiert mich dieser 7 GHz Unsinn ja auch so. Venice bleibt bei ~5 GHz, also lass Olympic Ridge überhaupt erstmal 6 GHz erreichen.
Ein grosser Teil des Zen3-IPC-Vorteils gegenueber Zen2 kommt vom 8-Kern CCX gegenueber dem 4-Kern-CCX von Zen2. Ryzen 3300 ist deutlich besser als Ryzen 3100 aufgrund der Verwendung nur eines CCX. Von daher wuerde es mich wundern, wenn AMD einen Zehn-Kerner mit drei CCX bauen wuerde. Zwei CCX koennte ich mir noch vorstellen: ein 8er-CCX, wenn Performance gebraucht wird, und ein 2er-CCX fuer wenig fordernde Daueraufgaben.
AMD hat bei Strix Point uind Krackan Point jeweils 2 CCX verbaut. Kerne mit unterschiedlicher Taktverhalten an denselben L3 Cache zu hängen hat AFAIU auch Nachteile. Wenn man die CCX aufteilt kann man alles besser abstimmen.
Und dann kommt eben der große Vorteil hinzu dass man ganze CCX abschalten kann und nicht nur einzelne Kerne und Cache und IF weiter betreiben muss.
Ergänzung ()
Philste schrieb:
Glaube ich nicht, deshalb amüsiert mich dieser 7 GHz Unsinn ja auch so.
6 GHz nicht zu erreichen wäre eine sehr große Überraschung.
Aber AMD wird bei der Frequenz nicht in die vollen gehen, da der Die eben auch für Server verwendet wird. Was im übrigen Travis Kirsch in einem Interview in Japan ausdrücklich bestätigt hat.
Sollten die Gerüchte stimmen dass AMD für Zen 7 classic 2 unterschiedliche CCDs auflegt, dann könnte ich mir Vorstellen dass die 8 Kern Variante an Frequenz Limit geht.
Bei Strix Point geht's nicht anders, weil man keine 12 Kerne an einen CCX fuer 8 Kerne haengen kann. Dass Krackan Point 2 CCX hat, waere mir neu, und alles, was ich dazu finden kann, laesst es mich bezweifeln. Hast Du einen Beleg fuer 2 CCX?
Kerne mit unterschiedlicher Taktverhalten an denselben L3 Cache zu hängen hat AFAIU auch Nachteile.
Welche? Die Kerne haben auch so voellig unterschiedliche Takte, ob einige Kerne dabei nicht ganz so hoch gehen koennen wie die anderen, spielt keine grosse Rolle. Hier z.B. die Taktraten der Kerne eines Phoenix zu einem Zeitpunkt mit Last auf einem Kern:
Code:
cpu MHz         : 1600.000
cpu MHz         : 1600.000
cpu MHz         : 2853.517
cpu MHz         : 2816.232
cpu MHz         : 4930.810
cpu MHz         : 2987.322
cpu MHz         : 2815.561
cpu MHz         : 2806.268
Und dann kommt eben der große Vorteil hinzu dass man ganze CCX abschalten kann und nicht nur einzelne Kerne und Cache und IF weiter betreiben muss.
Dafuer braucht man aber nicht 3 CCX, da reicht auch eine Aufteilung 8+2. Den IF muss man auch betreiben, wenn ein CCX (von mehreren) abgeschaltet ist, denn den benoetigen die uebrigen Kerne zum Reden mit den Speichercontrollern und der Peripherie. Bei mehr CCX wird der tendentiell sogar oefters gebraucht, naemlich zur Kommunikation zwischen den CCX.
Ein grosser Teil des Zen3-IPC-Vorteils gegenueber Zen2 kommt vom 8-Kern CCX gegenueber dem 4-Kern-CCX von Zen2. Ryzen 3300 ist deutlich besser als Ryzen 3100 aufgrund der Verwendung nur eines CCX.
Das ist aber ein Trugschluss. Es war nicht die CCX Anzahl, sondern die Verdopplung des Caches primär der Vorteil. Cache misses führen zu unnötig hoher Latenz und Wartezeit. Und ja, in deinem 4C vs 4C Beispiel stimmt das, dass der Single CCX besser als der Dual CCX ist. Aber das ist auch dort 2x8MB vs 1x16MB L3 Cache.
Auch wenn es Details sind, an genau diesen Stellen rächt sich das medial idR. vereinfachen von technischen Fakten. Wie eben das stumpfe addieren der Cache Teile, was auch in der CB Redaktion gern gemacht wird. Mit zwei CCX und der gleichen Menge Cache pro CCX wäre das kein nennenswerter Unterschied an der Stelle. Aber derartige Modelle gibts nicht.
Spannend(er) bleibt zukünftig dabei doch aber ein 12C CCD/CCX mit 50% mehr Cache zum 8C Model ggü. dem alten X3D Single CCD. Ob dann die 32MB Differenz und die 4 Cyclen höhere Latenz der X3D CPU noch vorn liegt oder nicht. Da AM5 gesetzt scheint, gibts wohl faktisch keinen IF Latenzboost wie bei Zen3 auf 4 damals.
Qualcomm hat es beim neuesten Snapdragon vorgemacht, wie man es NICHT macht:
L2 zwischen den Kernblöcken geshared und and die Takt- und Spannungsdomäne der Prime Cores gehängt.
Was ist passiert? Die Mid Cores sind jetzt entweder langsamer als die Vorgänger (weil der Cache nicht hochtaktet) oder der SoC benötigt bei gleicher Performance mehr Leistung (weil die P Cores ohne Last hochtakten müssen, damit der Cache hochtakten)
Großes Kino
AMD hat beim Zen 6 Dense CCD ein CCX mit 16 Kernen. Also gab es bei Strix Point kein grundsätzliches Problem. Das war ja auch der Grund warum ich damals sehr lange skeptisch war das es tatsächlih 2 CCX sind.
mae schrieb:
Dass Krackan Point 2 CCX hat, waere mir neu, und alles, was ich dazu finden kann, laesst es mich bezweifeln. Hast Du einen Beleg fuer 2 CCX?
Ich rede nicht davon den IF im SoC auszuschalten sondern das komplette CCX mit allen Kernen, SRAM und dem Abschnitt des IF das die Kerne des CCX untereinander und mit dem IF im SoC verbindet.
mae schrieb:
wenn ein CCX (von mehreren) abgeschaltet ist, denn den benoetigen die uebrigen Kerne zum Reden mit den Speichercontrollern und der Peripherie.
Das CCX ist über einen Port and das Inifinity Fabric des SOCs angeschlossen. Ebenso wie die einzelnen Kerne im CCX über einen Port an das Infinity Fabric anheschlossen sind.
AMD kann die Switches stillegen die das CCX ansteuern und alles was daran hängt. Nur die Switches für den Ringbus bleiben aktiv.
mae schrieb:
Bei mehr CCX wird der tendentiell sogar oefters gebraucht, naemlich zur Kommunikation zwischen den CCX.
Der Nachteil ist eher, dass der L3 aufgesplittet wird.
mae schrieb:
Welche? Die Kerne haben auch so voellig unterschiedliche Takte, ob einige Kerne dabei nicht ganz so hoch gehen koennen wie die anderen, spielt keine grosse Rolle.
Classic und Dense Kerne haben unterschiedliche Zielfrequenzen. Und wenn man die Kerne trennt, kann man den L3 Cache entsprechend anders auslegen.
fdsonne schrieb:
Spannend(er) bleibt zukünftig dabei doch aber ein 12C CCD/CCX mit 50% mehr Cache zum 8C Model ggü. dem alten X3D Single CCD. Ob dann die 32MB Differenz und die 4 Cyclen höhere Latenz der X3D CPU noch vorn liegt oder nicht.
Welche sollen das sein? Die 12CU RDNA3(.5) kommen nicht mal an eine RX570 & GTX 1060 vorbei. Und selbst die RX 9050 mit 16CU sollten immer deutlich schneller sein, als eine 12-16CU RDNA4 Mobile Low Power GPU.